DS V4.1 Pro可能拥有2万亿参数:另有8万亿版本,并押注国产芯片
据快科技9月21日报道,早前我们对中秋节和国庆节假期前后国内外计划推出的十余款大型语言模型进行了梳理,而其中关注度最高的当属DeepSeek V4.1 Pro。
以消息灵通著称的Theinformation再次带来新动态——DeepSeek当前正在训练一款拥有2万亿参数规模的大模型,并且后续还将进一步扩展至8万亿参数量级。
此外,该报道还透露,DeepSeek在大模型训练领域未来将重点倚重国产AI芯片,尤其是华为旗下的昇腾产品线,至于更具体的部署方案则未见详细披露。
8万亿参数的超大模型何时面世尚不可知,但文中提到的这款2万亿参数版本极有可能就是 imminent 的DeepSeek V4.1 Pro。只是具体落档月份仍存悬念,国庆前赶上的概率偏低,十月中旬至下旬的窗口更为现实。
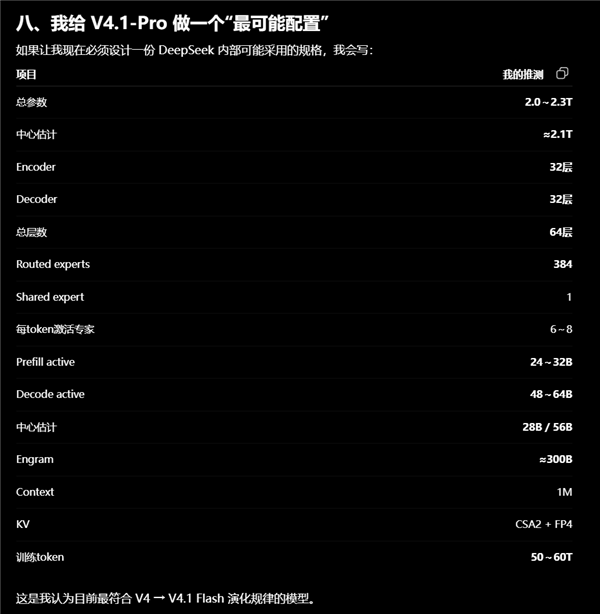
结合此前公布的DeepSeek V4.1 Flash相关信息可以推断,V4.1 Pro将继续沿用一套全新架构体系,涵盖CED+Engram机制、Prefill与Decode阶段解耦、非对称激活结构等核心设计。若交由AI做粗略推算,较为合理的参数配置大致如下:
要完成这样一个2万亿参数模型的训练,大约需要消耗50到60万亿个Token。以现有GPU算力水平来折算,H100/H200级别的加速卡需配备约3万张,英伟达B200则需1.5万张,华为910C大概要6万张;而如果采用昇腾950系列,需求量约为3万张,与H200基本持平。
DeepSeek新一代大模型的战略方向显然正与国产AI芯片深度耦合。华为昇腾950系列本身分为PR和DT两条产品线,分别对应训练与推理场景,恰好也将Prefill和Decode两个环节做了分离处理。DeepSeek的新架构设计明显是在配合昇腾平台做软硬件层面的联合调优,以同时提升训练效率和推理性能。
此前已有公开案例证明国产AI芯片能够支撑万亿参数级别大模型的训练工作,但涉及2万亿这一量级的尚无确切佐证。目前国内已公开的超过2万亿参数的大模型主要包括文心一言5.0、Kimi K3以及千问Qwen 3.8 Max,尚未发布的还有MiniMax M3等,但这些产品均未宣称采用了国产AI芯片来完成训练。
倘若DeepSeek V4.1 Pro确实在2万亿参数模型的训练过程中使用了国产AI芯片,哪怕并非全程覆盖,也足以被视为一项具有标志性意义的突破。
展望来年,华为昇腾960系列有望比原计划提前一到三个季度推向市场,长期制约国内大模型发展的算力瓶颈将在未来数年内得到显著改善,届时中国团队便具备了与OpenAI、Anthropic展开正面角逐的实力。