英特尔首款桌面NPU深度解析:它究竟能做什么?
英特尔于9月21日发布的酷睿Ultra 200S系列处理器,首次把神经处理单元(NPU)带入了面向高端玩家的传统台式机平台。
此举意味着经典桌面计算机正式跨入拥有底层人工智能硬件加速能力的阶段,其中定位最高的酷睿Ultra 9 285K是率先应用该项技术的标杆型号。
从参数来看,酷睿Ultra 9 285K在8颗高性能核心与16颗低功耗核心的基础上,额外嵌入了两组神经网络计算引擎模块。每组模块内含4096个乘累加单元并配有4MB片上存储,能够运行INT8与FP16两种精度的推理运算。
按照官方公布的数据,单颗NPU的峰值吞吐量为13 TOPS;若叠加中央处理器与集成显卡的计算能力,整套平台的AI综合算力上限可触及36 TOPS。
NPU的设计初衷是追求高能效比下的推理执行:它能够接管规模适中的AI计算需求,从而释放CPU和GPU去应对其余负荷。这正是它与大容量独显之间的根本差异——一张搭载张量核心的GeForce显卡在处理适配模型时往往速度更快,代价却是显著更高的能耗。
因此,NPU的使命从来不是取代GPU,而是承接那些适合并行执行、又要求极致能效比的计算任务。
在架构实现方面,英特尔为该NPU配置了独立的驱动程序层,使其以深度学习加速器的角色、作为一块独立计算设备向操作系统注册。
NPU内部的任务调度器负责将推理作业拆分至两块NCE瓦片上执行。开发者借助OpenVINO框架中的专用插件,可将NPU指定为推理目标节点,比如让NPU负责模型主体的前向计算,而CPU或GPU则继续服务于其他并发负载。
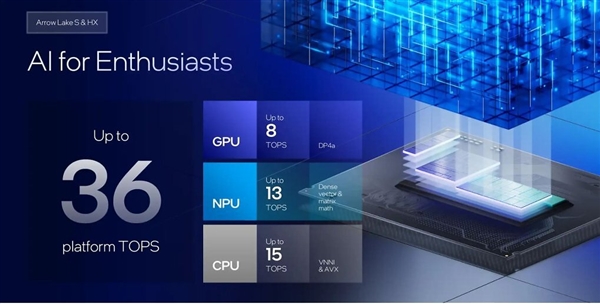
然而,13 TOPS的性能水平在当前标准下显然偏弱。微软对Copilot+ PC的一项硬性指标便是NPU算力须突破40 TOPS,而Core Ultra 9 285K上的NPU仅有其三分之一。换言之,尽管Arrow Lake-S已内置专用AI硬件,却仍无法达到微软大力推广的多项本地化AI功能所设定的性能底线。
这恰恰揭示了桌面级NPU长期以来存在感不足的根本原因:硬件确实就位、系统能够检测到、技术路径上也允许调用,但能否真正发挥作用完全取决于上层软件的适配程度。开发者必须在代码中明确接入对应的推理后端或运行时框架,例如依托OpenVINO配合英特尔提供的NPU插件来完成模型的编译与部署。
那桌面端的NPU究竟在什么场景下才能发挥价值?答案主要指向那些高频触发、或需与其他业务并行的小体量推理任务。典型用例涵盖在线会议里的实时降噪与虚拟背景替换、语音指令和图像内容识别,以及图片编辑、音频制作工具中的本地化滤镜效果等。
这类任务的共同特征是反复调用参数量不大的模型进行矩阵变换运算,天然适合卸载到专用NPU上去跑。在软件优化到位的前提下,各类任务可以被动态分派到各自最优的计算单元上协同完成。
但对于一台以游戏为主的台式电脑来说,眼下能从NPU获益的应用场景依然屈指可数,况且前提是程序本身必须显式声明对NPU的支持。一旦缺乏对应的推理后端,所有负载最终还是会回落到CPU和GPU身上消化。