华为紧追英伟达:将单卡比拼升级为集群对抗
"华为要做的,是成为英伟达的那个位置。"
9月14日,华为心声社区对外披露了一则座谈会记录——监事会主席郭平与一批新入职员工进行了面对面交流。当话题触及大模型领域的战略方向时,郭平少见的用极为坦率的措辞回应了这个问题。
与此同时,他也清晰地框定了范围。华为真正的核心竞争力并非自己手握一款顶级大模型,而是帮助客户打造优质大模型的能力,保证来自世界各地的各类大模型都能在其昇腾、鲲鹏、超节点以及集群平台上顺畅运转。
仅仅过了三天,9月17日的华为全联接大会2026上,一系列重磅发布接踵而至:昇腾960超节点、灵衢UnifiedBus互联协议、CANN开源生态、华为云Agentic Cloud、SCALE合作伙伴体系。将这些发布逐一串联起来审视,郭平那句表态便不再只是对内鼓舞士气的话术,而是一份背后有清晰产品规划托底的战略宣言。
那么,这份宣言的兑现程度究竟如何?从目前的情况判断,华为正在一块一块地将整幅拼图补完。
**从买家变为对手**
华为对英伟达的追赶之路,远非从昇腾面世那一刻才启程。
2020年以前,华为的芯片几乎全部依赖美国供应商,曾经还是英伟达在中国市场上体量最大的采购商之一。
彼时的华为承受着巨大的成本压力:旗下智能云硬件平台Atlas在推广过程中遭遇的最大瓶颈,便是服务器售价动辄六七十万,而其中光是英伟达的算力加速卡就要吃掉四十万。如此高昂的定价使得该系列产品在市场上几乎无人问津,大部分库存最终只能由华为自身消化。
不过,转向自主研发的信号其实早已埋下伏笔。
2016年CES展会期间,华为海思负责人何庭波与英伟达掌门人黄仁勋有过一番对话。当时英伟达刚宣布逐步退出移动芯片赛道,何庭波试探性地提出是否可以将相关技术转让给华为,结果遭到黄仁勋当面回绝。
正是这一次碰壁,彻底坚定了何庭波投身AI芯片赛道的信念。回到国内后她接洽了寒武纪,起初考虑选用对方的芯片方案,但在听完创始人陈天石的技术分享后,她意识到华为内部同样汇聚了一批出身中科大少年班的顶尖人才,于是将AI处理器研发的担子交给了廖恒。2017年,内部代号"达芬奇"的AI芯片预研项目正式获批启动。
如今的廖恒已升任华为半导体首席科学家。他带领团队对过去十余年的深度学习研究成果做了系统性复盘,最终找到了一条截然不同的技术路径。
彼时英伟达选择的是"模块化组装"式的CMP(多芯粒异构封装)方案,其最大亮点在于一套极为精巧的多线程调度机制,能够驱动海量线程并发执行。但这种架构更像一位面面俱到的通才,并未将AI最关键的运算效率压榨到极限。
华为的判断非常明确:若逐像素复刻英伟达的设计,产出的产品充其量便宜一些,性能却难以匹敌。因此,华为果断转向了DSA(面向特定领域深度优化的专用架构)方向。
传统CPU采用顺序处理方式,一次只算一步;英伟达的GPGPU走的是大规模并行路线,让数以万计的线程同时运转。华为两者皆未采纳,而是将计算单元重新构造成三维立体方块矩阵。这一设计使芯片每瓦能耗所能转化的AI算力获得了质的飞跃。
2018年年中,自研昇腾芯片项目全面铺开,重点锁定数据中心推理卡和边缘计算两大应用场景,目标直指英伟达GPU。
然而华为迅速意识到,仅有芯片远远不够。早先为了摆脱对国外软件的依赖、独立完成二次开发,华为搭建了一套支持资源池调度和二次封装的CUDA替代层,实现了关键突破。据方兴东所撰写的《晟腾崛起》一书记载,华为曾向英伟达寻求授权合作,但被对方一口回绝——理由有二:一来这直接威胁到英伟达依靠硬件销售获取利润的根本商业模式,二来需要英伟达工程师长期驻场提供支持,会大幅推高运营成本。
此路既断,华为决定另辟蹊径。不再与英伟达在单一芯片的参数和性能指标上短兵相接,而是将产品形态升级为整机、整架、整集群乃至整个规模化数据中心。这一转变赋予了华为更大的架构设计空间,也成功避开了单卡对决的主战场。
不过,志在成为中国版英伟达的玩家绝非华为独一家。
2025年末至2026年初,摩尔线程、沐曦股份、壁仞科技、天数智芯这四家本土GPU企业扎堆完成IPO,燧原科技也于2026年9月成功登陆科创板。媒体纷纷将它们冠以"中国英伟达"的称号。摩尔线程掌舵人张建中早年担任过英伟达中国区总经理,壁仞科技CTO洪洲曾主导华为海思自研GPU项目,沐曦的核心班底亦带有英伟达和AMD的深厚烙印。
然而在"中国英伟达"这同一面旗帜之下,各家实际行走的路径各不相同。四小龙之中,摩尔线程、沐曦、壁仞均押注GPGPU路线,追求与CUDA生态的兼容性,力求让既有代码尽可能平滑迁移;燧原科技与华为昇腾一样走了DSA路线,但燧原选择放弃对CUDA的兼容,意味着必须从零搭建整套软件体系。
壁仞科技招股书中援引灼识咨询的数据表明,2024年度英伟达与华为海思(依据附注信息推断)合计把控了中国智能计算芯片市场94.4%的份额。
在如此极端的头部垄断格局下,其余国产AI芯片创业公司在2024年大多仍处于起步阶段或商业化早期,"四小龙"加在一起在国内AI芯片市场的占有率不足2%,而华为昇腾已然成为其中市场份额最高的本土品牌。
换言之,喊同一句口号的企业不在少数,但真正在系统层面、集群层面与英伟达展开正面角力的,眼下唯有华为。
七载磨一剑,昇腾960标志着这套系统化打法首次完整落地。
**追赶的速度与仍存的代际落差**
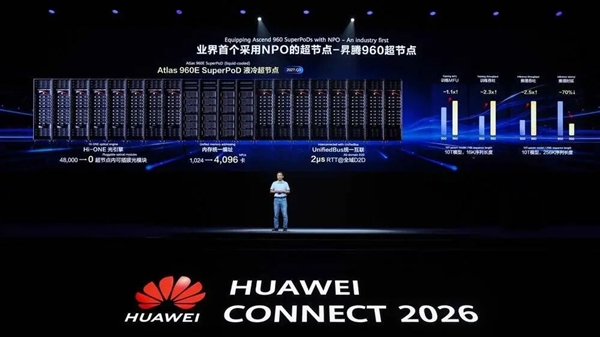
昇腾960系列芯片的提前揭幕成为本届大会最受关注的焦点。轮值董事长汪涛在会上宣布该系列已"提前达到研发就绪状态",并公布了加速后的产品发布时间表。
其中,面向训练任务的昇腾960DT比原定计划提前三个季度,将于2027年一季度交付就绪;面向推理任务的960PR提前一个季度,定于2027年三季度到位。后续的970、980型号将维持每年更新一代的节奏。
按照华为官方披露的性能指标,昇腾960DT的核心运算能力和存储带宽相较前代实现了倍增。
综合多方行业分析数据,其整体性能超越了英伟达2023年推出的H200 SXM,但仍落后于2025年下半年起批量出货的B300。前者属于英伟达的上代旗舰,后者则是其当下在售的主力型号。
换言之,昇腾960的单卡实力大约等同于英伟达两年前发布的水平,尚未追上对方当前在售的主力产品。
图片来源:华为提供
华为并未回避单卡层面的差距,而是选择用另一套思路来弥补。
华为内部曾进行过算力效率的横向对比。在同等有效面积内,华为的算力密度暂未能达到英伟达的巅峰水准,只能通过服务器、集群等层级来提升整机的算力输出,代价则是功耗偏高。
这种现实倒逼华为深入思考大模型究竟需要怎样的硬件底座,得出的结论是:OpenAI与英伟达在底层形成了深度绑定,犹如当年微软与英特尔的关系,因此华为必须紧紧咬住英伟达不放。
华为认为自己相比英伟达拥有一项独特优势——能够让CPU与GPU之间充分互通、协同工作。但协同的基础是高速互联,而互联恰恰是英伟达布局更为前置的领域。
英伟达早早推出了NVLink互连技术,又收购了Mellanox,比其他厂商提前约三年洞察到互联的关键价值。因此当ChatGPT-3.5掀起浪潮时,华为在互联技术上已落后一到两年。
差距客观存在,华为的策略是在存储环节加码投入,进行定制化部署。
据《晟腾崛起》记载,华为内部对英伟达的竞争方针被浓缩为一句话:像蛇一样,用漫长的链条和迂回包抄的方式死死缠住对手。
直到2023年年中,910B芯片重新归队,华为方才修复了此前的架构性短板,同步开放了底层接口能力,使用户可以借助集群计算所提供的工具链自主开展开发。到同年六月,推理芯片性能已达到英伟达同级别产品的1.6至1.7倍。这便是"缠绕"策略结出的第一枚果实。
2026年初,华为管理层专门召开昇腾业务专题研讨会议,对"超节点+集群"一体化方案予以高度重视,进一步明确了昇腾的战略定位,并决定优先保障头部客户的大规模算力诉求,同时通过一体机产品线覆盖中小型算力场景。至此,在中国市场上具备大规模商用能力且能稳定承载上万节点集群持续运行的AI芯片,仅有华为昇腾一款。
其背后的逻辑十分清晰:华为的真正竞争力不在单张卡片,而在整个集群。
**以超节点突破单卡天花板**
全联接大会上,汪涛正式发布搭载NPO技术的昇腾960超节点,并透露将在2027