AMD首款全栈AI机架亮相:72块GPU自研芯片,对标英伟达
AMD正式抛出重磅炸弹,首个全栈机架级AI方案Helios将在Advancing AI 2026活动上发布。官方已公布详细规格,从GPU到CPU再到网络芯片全部自研,直指NVIDIA现有的Oberon和即将推出的Kyber机架。
这不仅是产品的更新,更是战略的全面升级。 说白了,Helios不是那种直接卖的独立整机,它是一套“开放机架级参考设计”。这套设计采用了Meta提交给OCP的Open Rack Wide标准,整体走全液冷路线。
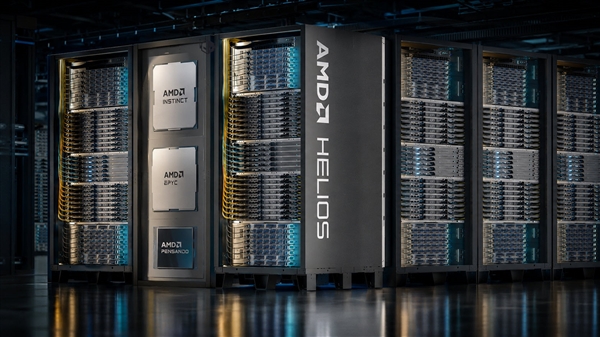
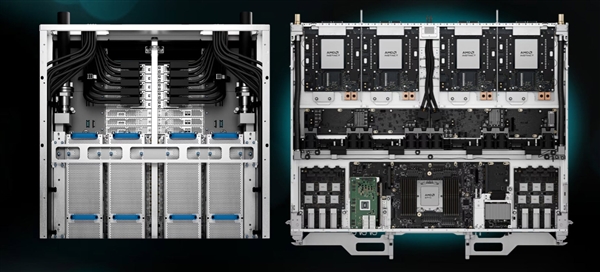
整个机架里塞了18个计算托盘和6个交换机,结构相当紧凑且高效。 每个计算托盘的配置很硬核,装了4块Instinct MI455X GPU和1颗EPYC Venice CPU。算下来,整机架总共搭载了72块GPU。
每块GPU都覆盖了铜制液冷冷板,散热压力不小。整机架重量约5000磅,也就是2268公斤左右,功耗在225到245千瓦之间。 有报道说,这么一套机架的成本大概在500万到550万美元之间。这个数字对于数据中心来说,是个不小的投入。
但考虑到它的算力密度和能效表现,这笔账可能值得细算。毕竟,算力就是未来的生产力。 再看具体算力指标,Helios能提供2.9 Exaflops的FP4算力和1.4 Exaflops的FP8算力。它还搭载了总计31TB的HBM4内存,聚合带宽高达1.4PB/s。
纵向扩展互连带宽是260TB/s,纵向扩展带宽则是43TB/s。 CPU和GPU的核心总数也相当可观,分别达到了4600个和18000个。这些数字背后,是AMD在高性能计算领域的深厚积累。每一个核心都在为大规模AI任务默默耕耘。
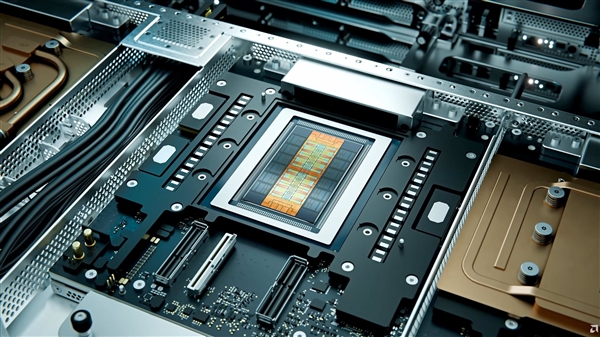
Helios的三大核心组件分别是Instinct MI455X GPU、第六代EPYC Venice CPU和Pensando网络芯片。这三者协同工作,构成了完整的计算系统。它们各自承担不同的角色,共同推动着AI算力的爆发式增长。
GPU方面,MI455X基于CDNA 5架构,单卡能提供40 PFLOPS的FP4算力和20 PFLOPS的FP8算力。相比上一代MI350系列,算力直接翻了一倍。作为对比,NVIDIA的Rubin GPU提供50 PFLOPS的FP4和17.5 PFLOPS的FP8算力。
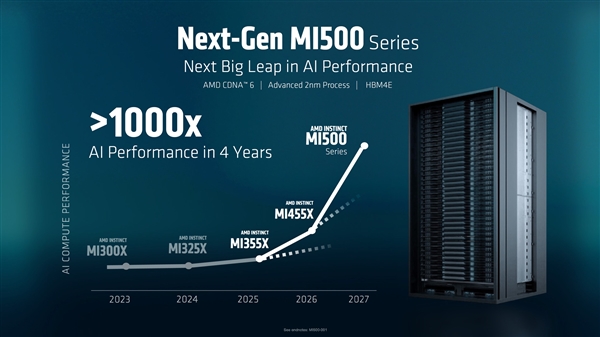
在FP8算力上,AMD确实领先了一步。这种优势在特定类型的AI训练中可能会体现出来。当然,算力只是其中一个维度,还有其他因素需要考虑。比如内存容量和带宽,这也是决定性能的关键要素。 MI455X的内存配置也很亮眼,从MI350系列的288GB HBM3e升级到了432GB HBM4。
容量提升了50%,带宽从8TB/s跃升到19.6TB/s,提升超过一倍。NVIDIA的Rubin GPU配备的是288GB HBM4,带宽22TB/s。 AMD在内存容量上领先了50%,这是一个显著的优势。
更大的容量意味着能加载更大的模型分片,减少跨节点通信开销。这对大规模推理场景尤其关键,能让模型跑得更快更稳。 MI455X属于MI400系列中的三款产品之一。另外两款是MI450X和MI430X。MI455X和MI450X主要面向大规模AI训练和推理,而MI455X专门为Helios机架打造。
MI430X则瞄准HPC和主权AI场景,具备最强的FP64计算能力。 CDNA 5架构还带来了基于标准的机架级网络互连支持,包括UALoE、UAL和UEC等开放标准。这与NVIDIA依赖NVLink和InfiniBand的封闭路线形成了鲜明对比。
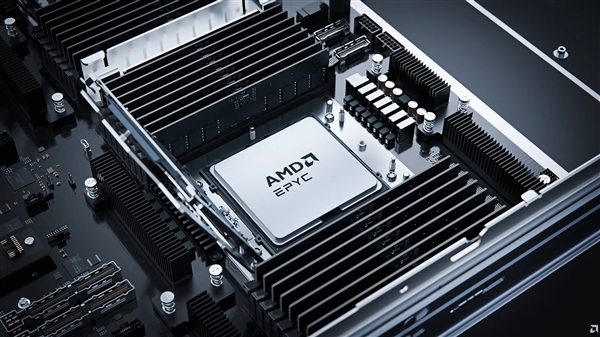
开放标准的好处在于兼容性和灵活性,更容易融入现有的基础设施中。 CPU方面,EPYC Venice是首款基于Zen 6架构的HPC产品,也是台积电2nm工艺首个进入量产的高性能计算芯片。台积电2nm工艺从FinFET转向GAA晶体管架构,同功耗下性能提升10至15%,同性能下功耗降低25至30%,晶体管密度提升最高15%。
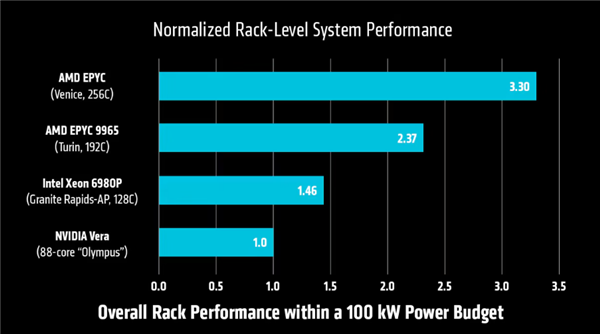
Venice最高配备256核心512线程,采用8个大型计算芯片和2个更大的I/O芯片的多芯片封装设计。性能和能效提升超过70%,线程密度提升超过30%。这种设计让它在高密度计算场景中表现出色。 目前,Agentic AI工作负载对CPU性能的要求正在急剧攀升。
AI Agent需要频繁的调度、内存管理和数据预处理。AMD早期的基准测试显示,第五代Turin已在性能上领先NVIDIA基于Arm架构的Vera CPU。第六代Venice的领先幅度还会拉大,在相近功耗下提供更高性能和更优的TCO。
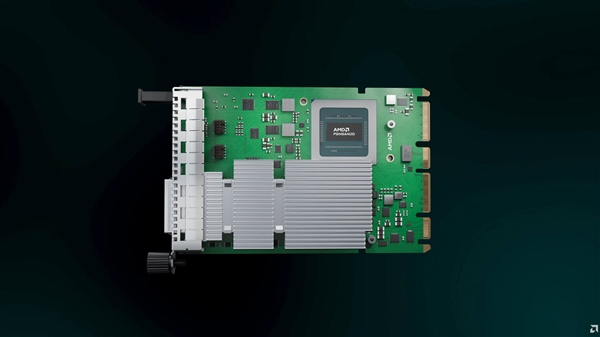
网络互联方面,Helios搭载了Pensando Vulcano 800 AI NIC和Salina DPU。Vulcano 800提供800 Gbps以太网吞吐量,是目前唯一提供单GPU最高2.4Tbps纵向扩展带宽的网卡,是其他方案的8倍。
这个速度足以应对最苛刻的数据传输需求。 通过UALink/PCIe Gen6主机接口,GPU间的通信实现了超低延迟。它还支持UEC标准和RDMA以太网优化。基于UALoE开放标准,Helios实现了机架内最多72块GPU的高速互连,正好对应单机架的GPU总数。
这种设计确保了数据传输的高效性和稳定性。 Salina DPU搭载了16个Arm N1核心,负责网络、安全和存储卸载。它的处理速度比仅用CPU处理快了40%,性能是AMD上一代DPU的两倍,也比NVIDIA BlueField-3 DPU快40%。
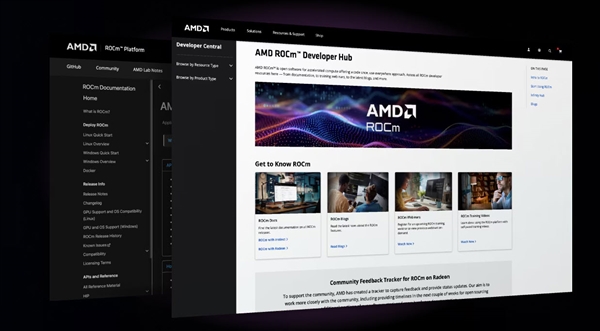
这意味着更多的资源可以留给核心的计算任务,而不是被琐碎的网络操作占用。 软件生态方面,AMD ROCm已更新至7.14版本,原生支持PyTorch、TensorFlow、JAX、Hugging Face、vLLM、SGL、Deepspeed、ONNX、llm-d、OpenXLA、MLID、Llama Stack等主流框架,并提供Day-0支持。
AMD强调其采用开放硬件和软件标准,降低集成复杂度,与NVIDIA封闭生态形成差异化竞争。 客户方面,微软已经宣布将部署Helios机架用于Azure AI服务,提供三种实例。一种是面向CPU密集型负载的Azure HDv2,有近500个EPYC核心、4TB内存、32TB NVMe存储和400Gb Azure Boost网络。
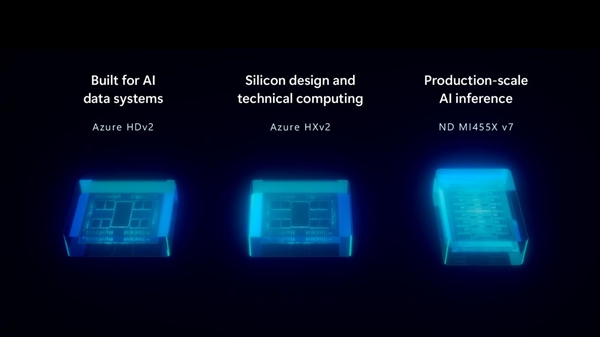
另一种是面向Agentic AI的Azure HXv2,配备176核心3D V-Cache、5GHz+频率、50%更多缓存、2至4TB内存和800Gb InfiniBand。 还有一种是搭载72块MI455X GPU的ND MI455X v7实例。
此外,OpenAI、Meta、Oracle、HPE、TCS、Celestica、Nutanix和美国能源部也确认采用Helios方案或相关产品。这些巨头的背书,无疑为AMD的新品增添了分量。 这场AI硬件的竞争,已经从单纯的算力比拼,演变为系统级能力的较量。
AMD这次的全栈出击,能否撼动NVIDIA的地位,还得看后续的实际落地效果。不过,开放生态的优势或许会在长期竞争中逐渐显现。