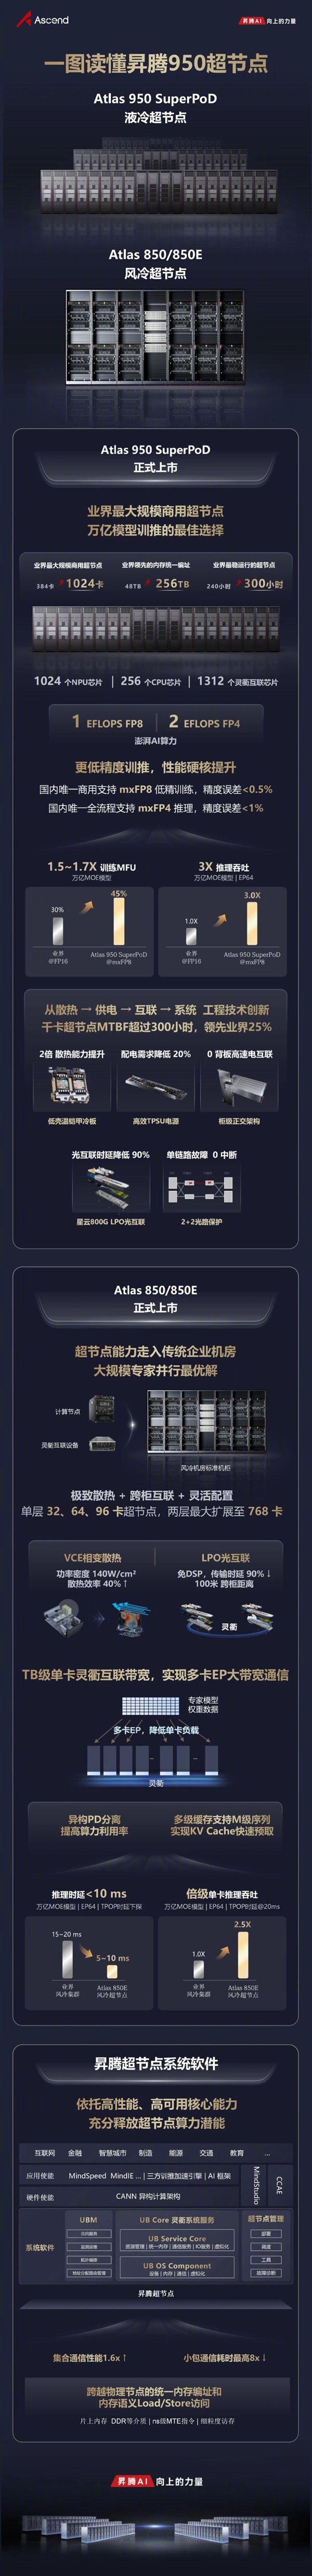
华为昇腾950超节点正式发布:1024卡规模领跑业界,一图速览
2026年世界人工智能大会期间,华为正式亮相了目前行业体量最大的超节点整机——昇腾950超节点实物。该设备是华为针对万亿参数大模型训练及大规模并发推理任务所研发的液冷AI算力集群,其核心思路是将超过一千片NPU整合为一台逻辑上完全统一的巨型计算系统,从而突破大模型训练中多卡间通信延迟的制约。
整个超节点的计算引擎由昇腾950DT NPU芯片驱动,每颗芯片均围绕大模型训练与解码推理进行了深度调优,配备HiZQ 2.0规格的高带宽显存,单卡HBM容量达144GB,带宽高达4TB/s,可处理FP16、BF16、FP8、MXFP4等多种精度的AI运算,覆盖大模型预训练、长文本上下文推理以及MoE混合专家架构等多种应用场景。
在硬件布局方面,该系统遵循模块化设计理念,基础组网包含16个计算机柜和4个灵衢互联机柜,极限配置下可容纳1024片昇腾950DT NPU并搭配256颗鲲鹏950 CPU,峰值算力可达1 EFLOPS(FP8)及2 EFLOPS(FP4)。
互联层面,华为借助自主研制的灵衢2.0全光互联协议,实现了机柜之间的全光Mesh拓扑直连。整簇集群的聚合互联带宽达到1.72PB/s,跨机柜信号往返时延压缩至3微秒以内。与此同时,系统支持256TB全局内存的统一地址映射,使上千片NPU能够共同访问同一块内存区域,无需再像传统架构那样在多台独立机器之间反复传输庞大的模型权重,从而显著削减大模型训练中的通信开销。
温控方面,该集群全面采用液冷散热架构,单个机柜最高可承载100kW的电功率输入,保障高密度算力的长期稳定输出。在冗余设计上,灵衢链路配备了2+2光路热备机制,并具备瞬时断开后自动重建连接的能力——即便局部链路出现异常,上层业务仍可正常运行,确保7×24小时无间断的大模型训练作业不受影响。
软件栈方面,该产品构建于昇腾CANN全栈软件平台之上,提供完整的开发工具链,涵盖模型快速迁移与分布式训练策略优化等功能。
在传统AI集群中,随着参与计算的服务器数量增加,节点间的数据同步成本急剧攀升,整体算力利用率随之下降。昇腾超节点的关键突破在于消解了单机器的物理隔离,令上千颗NPU以"一台机器"的方式协同工作,大幅提升了万亿级参数模型的训练吞吐,尤其契合Agent智能体、超长窗口大模型等对算力有极致要求的新兴负载。
按照既定节奏,该超节点预计于2026年第四季度完成商用发布,后续还支持将多套超节点进行级联互联,向更高层级的算力集群持续演进。