高通发布新NPU:两大变化,专攻智能体AI
继CPU和GPU之后,高通终于亮出了新一代旗舰处理器里的Hexagon NPU。这次更新,瞄准的是终端侧智能体AI。 高通技术公司产品市场高级总监Cisco Cheng在署名博客里说,智能体AI会定义移动计算的下一个时代。
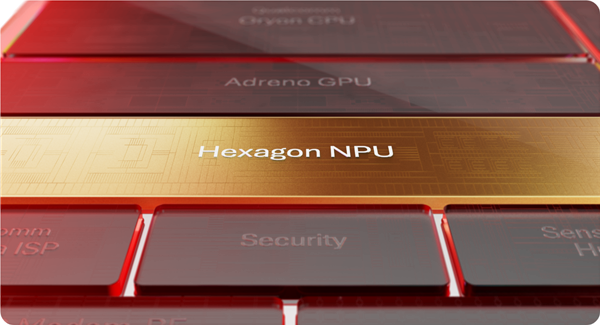
这类系统得懂用户的情境,还能跨应用干活,持续推理,照着用户的意图去操作。 说白了,移动端AI芯片光算得快不够了。它还得能持续算、低延迟地算,同时处理多个任务的协同计算。 为了接住这波趋势,新一代Hexagon NPU带来了两个关键改动。
一个是Element Accelerator,另一个是更大的共享内存系统。 Element Accelerator是这轮架构升级的重头戏。它专门给Transformer工作负载做了优化,把向量计算单元和标量计算单元捏到了一起。
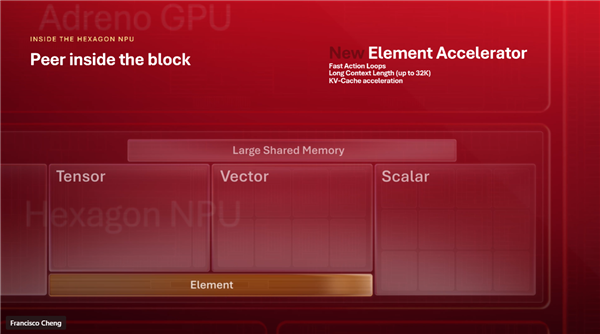
标量单元管着智能体的决策逻辑、路由和编排。向量单元则负责高吞吐量的AI数学计算,帮大模型推理提速。再配上Fast Action Loops和KV-Cache加速,它能撑住最长32K的上下文长度。 另外,模型越来越大,AI性能的卡点不一定在算力上。
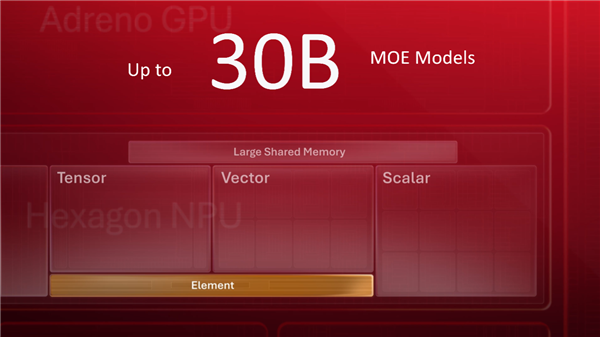
数据在计算单元和外部内存之间来回搬,也会带来延迟和耗电。 所以,新的共享内存系统容量比上一代多了50%。它把模型状态、上下文和KV-cache放在离加速器更近的地方,少跑外部内存一趟。这样,智能体处理长上下文、调更多工具、干更多并发活儿时,反应还是很快。
高通还在跟内存和模型厂商合作,想把MoE混合专家模型塞进终端侧AI架构。这样一来,大参数模型在手机上跑起来就成了现实。 举个例子,一个300亿参数的MoE模型,每生成一个词元,只激活约30亿个被路由选中的参数。
加上基于闪存的模型加载和缓存技术,就能用低功耗和低内存需求,跑出大模型级别的AI体验。 精度这块,平台支持INT2、INT4、INT8、FP8和FP16。开发者可以在性能、内存、模型质量和功耗之间自己找平衡。
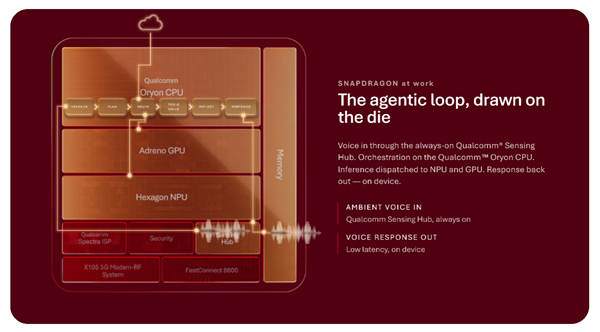
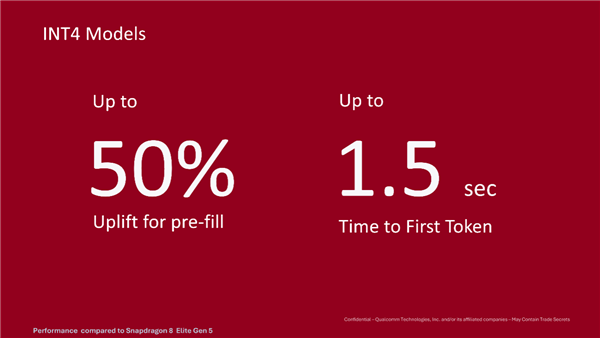
拿基于INT4的模型来说,预填充性能最多能提50%,首词元生成时间压到1.5秒,解码吞吐也更快,还有推测解码加持。 看整个架构,高通想做的已经不只是个AI加速器,而是一整套围着终端侧智能体AI搭起来的计算体系。
AI功能越来越多地从云端往手机上挪,本地算力要扛的事儿也越来越杂。高通这回在NPU计算单元、共享内存、模型架构和精度支持上的布局,就是在给下一阶段端侧AI铺路。 新一代旗舰平台到底啥样?答案会在9月22日到24日的夏威夷骁龙峰会上揭晓,北京时间就是9月23日到25日。