DeepSeek V4 Pro编程榜第二 成本仅榜首1/14
国产大模型在编程领域的较量又有了新看点。CLUE团队近日发布了SuperCLUE-Terminal中文智能体终端编程测评榜单,新版DeepSeek-V4-Pro-0813拿下51.52分,位列全场第二。
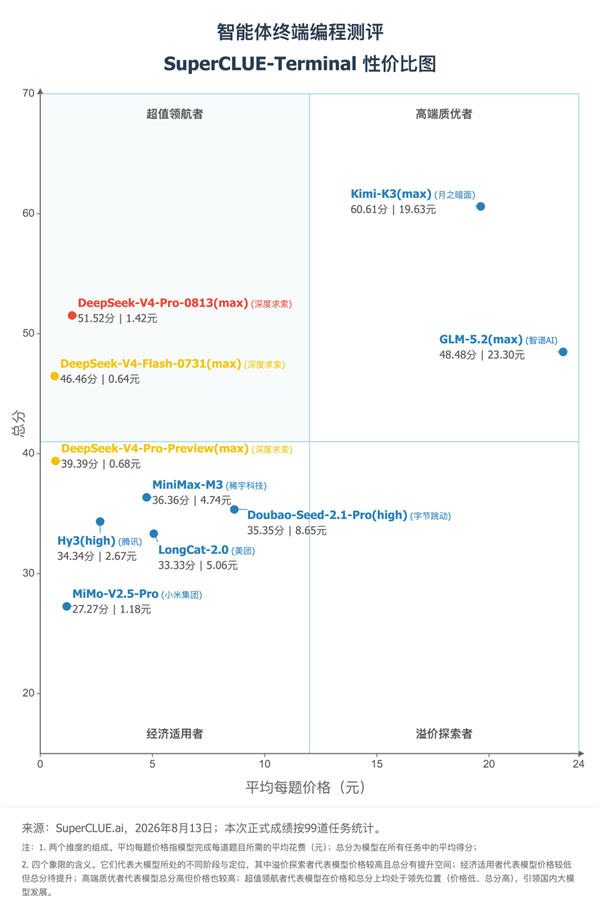
这个成绩紧咬冠军Kimi-K3,但成本优势却拉开了巨大差距。 说白了,这次测评就是给国内开发者量身定做的实战考试。所有题目都来自本土真实编程场景,统一用Claude Code当运行框架,专门考模型理解中文需求、拆解任务、调用工具和修bug的全套本事。
每道题要来回交互50到110轮,跑完一题得花半小时到一个半小时,跟平时写代码的节奏几乎一样。 榜单上,Kimi-K3以60.61分坐头把交椅。DeepSeek-V4-Pro-0813虽然没拿第一,但比GLM-5.2的48.48分和老版DeepSeek-V4-Flash的46.46分高出一截。
真正让人眼前一亮的,是它花钱少得离谱——单题调用只要1.42元,差不多是Kimi-K3的四分之一,GLM-5.2的十六分之一。 测试场景覆盖了前端页面、3D游戏和工程脚本修改这些硬骨头。实测下来,它能完整跑通游戏开发的整套流程,碰撞检测、计分系统、结果结算全都正常,连页面配色和交互反馈都没那股子模板化的AI味儿。
当然也有短板,少数创意绘图类的题目会冒出点结构上的小毛病,但整体完成度依然稳在第一梯队。 这事儿对中小企业和独立开发者太重要了。那些冲在最前面的高分模型,算力成本高得吓人,小团队长期用根本扛不住。DeepSeek-V4-Pro-0813用更亲民的价格,逼近了顶级模型的代码能力,算是把性价比这块蛋糕做到了极致。