国产GPU大单落地,壁仞科技1.74亿独家中标,45天完成供货
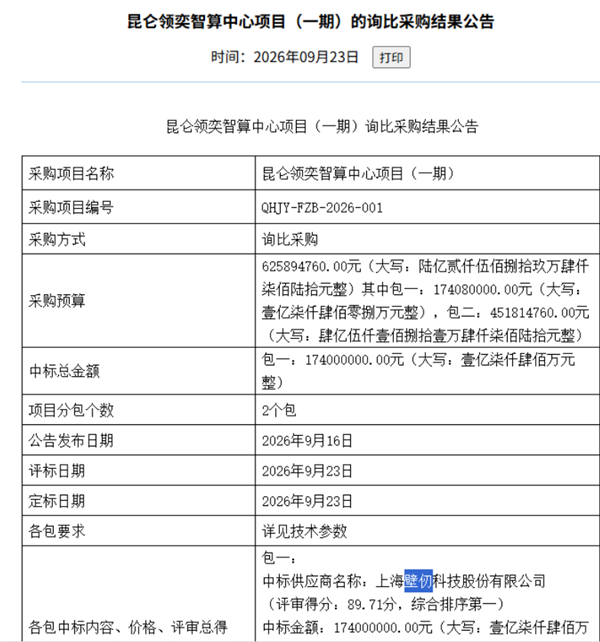
国产算力圈又传来重磅消息。昆仑领奕智算中心一期项目的询比采购结果,最近正式对外公布了。上海壁仞科技这次拿下了头筹,以1.74亿元中标了项目包一,而且成了这个包的唯一供应商。说白了,就是独家供货。 这事儿得从头捋捋。
整个项目的采购预算总盘子大概6.26亿元,分成了两个包来招。包一的预算是1.74亿元,包二的预算则有4.52亿元。壁仞科技在评审中拿到了89.71分,综合排名排到了第一位,这才稳稳当当拿下了包一。不过合同里写得明明白白,壁仞必须在签合同后的45个自然日之内,把所有货都供到。
这次中标的核心产品,是壁砺系列的GPU。公开资料里提到,壁砺GPU走的是经典的GPGPU架构路线。它的核心计算单元叫SPC流处理器,里面还集成了专用的张量计算单元,也就是T-Core。目前这家公司已经形成了BR106、BR110、BR166这三代产品的矩阵。
下一代的旗舰训推芯片BR20X,目标是在2026年上市,到时候会支持FP8和FP4这些数据格式,内存也会更大,互连带宽也更高。 聊到技术细节,互联能力算是壁仞的一个差异化亮点。他们自研了一套叫BLink的协议,能让GPU卡之间直接相连。
单通道的双向带宽最高能跑到64GB每秒,最多可以搭出8卡的点对点直互联。再往大了说,在Scale-out层面,他们用上了OCS光电路交换的方案。截至2025年底,已经成功交付了一个2048卡的光互连光交换GPU超节点集群,千卡集群的线性加速比达到了95%。
在生态适配这块儿,壁仞现在已经有能力对主流大模型做Day 0级的适配了。像智谱的GLM、DeepSeek、阿里的Qwen、还有月之暗面的Kimi这些国内的头部模型厂商,都在他们的覆盖范围内。自家的BIRENSUPA软件平台,也支持PyTorch、TensorFlow、飞桨这些主流框架,连vLLM这类推理框架也能跑起来。
这里有个值得留意的点。包二因为递交响应文件的供应商不够三家,最后被按废标处理了。一个预算超过4.5亿元的标包,就因为参与厂商数量不够而流掉了。这从侧面就反映出了,眼下国产AI算力供应链的集中度和稀缺性有多明显。