华为超节点硬核亮相:老黄说这话我信了
AI圈现在最缺啥?算力,绝对是算力。 这事儿没商量。 在国内,算力几乎是大模型厂商头顶的最大压力。 训练要靠它,国产大模型参数动辄几万亿,没算力玩不转。 模型练好了,用户多了,算力跟不上,体验立马拉胯。
高端的英伟达卡不卖给我们,低端的还得加钱排队。 说白了,国产算力卡就算不如英伟达顺手,国内大厂也不敢把鸡蛋全放一个篮子里。 华为昇腾、寒武纪、壁仞,都在国产算力里占着一块地盘。 眼下算力圈最热的词儿,叫“超节点”。
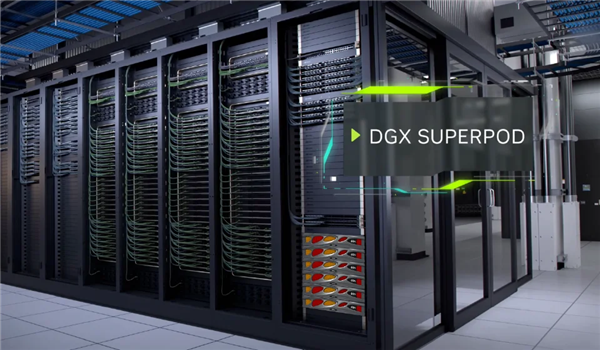
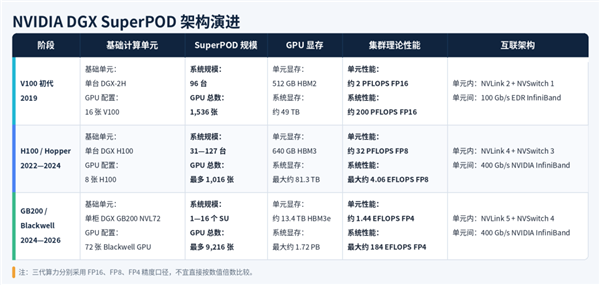
这词儿在国产显卡圈不算新鲜,但最初做这种形态的,其实是英伟达。 早在2019年前,虽然还没大模型,但语音、图像识别已经催生大算力需求了。 单卡不行,那就多张拼一起。 但大家发现,100张卡拼一起,实际算力只有三四成。
为啥?粗暴拼接,通信带宽差,数据流动慢。 各家服务器没标准,模块适配度也烂。 英伟达出了套自研NVLink协议,加上InfiniBand组网,再配上专属软硬件。 16张V100拼成一个超节点,最多96台服务器、1536张卡互拼。
业内说,英伟达把显卡利用率从四成拉到八成。 整体性强,开箱即用,有效算力高,企业自然买单。 反观国产显卡,单卡性能确实赶不上英伟达最新款。 但超节点给了新思路:单卡不行,拼数量啊。 只要系统开销稳得住,大力出奇迹,咱最擅长了。
去年华为CloudMatrix 384一出,国产显卡在超节点上总算迈出门槛。 正好赶上DeepSeek爆火,推理训练需求巨大。 384超节点刚好满足推理,顺势带火。 今年上半年,昇腾950组成的超节点开始交付。
单机柜64卡,16个机柜,共1024张卡统一编址。 对比英伟达NVL72,那是72张GB200。 抛开CUDA生态不谈,只看纸面参数,昇腾950超节点已能和英伟达最新款掰手腕。 上周华为全连接大会,直接把昇腾960超节点规模推到4096张卡。
明年一、三季度交付。 昇腾960性能比950翻一倍,互联架构也更优,时延、统一内存池都有提升。 华为超节点里,昇腾名字最熟,但其他关键技术大家知道不多。 排第一的,必须是“灵衢协议”。 制约服务器算力的,核心就是数据互通,也就是协议问题。
以前各零件、模块、节点都有自己的协议,碎片化严重。 数据反复转换,延迟高,还浪费算力。 英伟达用NVLink加InfiniBand解决。 华为靠通信起家,重新设计互联协议,简直是手拿把掐。 服务器内、节点间、集群间都能用灵衢通信。
相比英伟达的分层传递,灵衢更统一。 为了让更多厂家跟进,华为还把灵衢开源了。 我愿称它为超节点的灵魂技术,有了它打底,其他技术才能发挥威力。 协议打通后,硬件上也有大动作。 华为发布了业内首个基于NPO的光互联产品Hi-One。
2026年A股最火的是光模块,为啥? 训练大模型时,柜间通信必须靠光模块传信号。 为啥不用电缆?长距离高速电信号有电磁干扰和衰减问题,功耗还离谱。 光信号才能保证速率和功耗。 英伟达万卡级超节点集群,通常配4.5万到5万颗光模块。
看下图,左边是传统光模块,密密麻麻装在机柜背部。 它们离显卡芯片有几十到100厘米距离,这段必须走电信号。 为保证信号无误,需要专用DSP做时钟恢复和信号重整,功耗极大。 华为的Hi-One不一样,用了NPO近封装光学技术。
光引擎尽量放在芯片5厘米以内,省掉大部分电路传输开销。 Hi-One内置多通道激光器,每根光纤还用波分复用技术,一根光纤传多种信号。 华为说,5500个Hi-One就能替代原本4.8万颗800G光模块。
数量减少90%,信号更可靠,功耗还大幅下降,三赢局面。 今年还有个值得一提的技术,叫鲲鹏超节点。 鲲鹏是华为CPU芯片系列。 年初MWC上我就见过,那时主要服务于银行等数据库密集场景,最多16个节点。
今年大模型强调Agent,对CPU重视度飙升。 Agent要跑代码、调浏览器和数据库、处理文件、管上下文,在不同工具间调度,全是CPU的活。 现在大模型Agent开销以万计,CPU不强,根本负载不起。
所以,英特尔、AMD股价跟着吃肉,英伟达也做了面向Agent的Vera CPU。 这次鲲鹏超节点,型号还是鲲鹏950,但支持节点数进化到4096个。 统一内存池升到256TB,内存利用率和速度加快。
AI沙箱启动速度比传统方案快30倍。 用数量和架构补足单CPU性能的短板。 据说下一代鲲鹏960要用韬定律,性能应该更强。 这次全连接大会还公布了其他技术,比如OceanStor M900。 它是面向大模型上下文记忆的PB级存储产品,节省数据和存储间的搬运时间。
还有远近内存统一编制技术,让超节点全局内存统一编址。 处理器能更快访问本地和其他节点内存。 总结一下:昇腾960负责AI计算,鲲鹏超节点负责通算和Agent运行,OceanStor M900负责记忆。
灵衢和Hi-One把它们连接起来,组成Agentic AI超节点集群。 这套东西在工程上确实走在前面。 比单卡算力,我们确实不如国外,甚至差得远。 但超节点看重综合性能,比拼的是系统架构优化能力。 以后大模型参数奔10T去了,那就配10万张卡的超节点集群。
华为能做到这份儿,和各领域的积累密不可分。 协议能做、芯片能自研、常年跟数据打交道。 说到Hi-One,我挺好奇华为咋成了业内第一个量产NPO产品的厂家。 问了下AI,答案来了:华为做光通信30年了,一直研究怎么用光纤传超大量高速数据。
以前用在运营商骨干网、接入网的光技术,换个方式跑进超节点。 oDSP光数字信号处理器、WDM波分复用、硅光技术都能复用。 不夸张地说,超节点里的各方面,华为以前都涉及过。 加上工程化能力强,全套自主自导,拿出的东西自然让业内惊艳。
英伟达肯定也想全套自己做,不想被供应商拖后腿。 说不羡慕是假的,但确实没那么多积累,一下子铺不开那么大。 上半年老黄在播客里说:“DeepSeek首次跑在华为芯片上,对美国是个可怕的结果。” 当时大家觉得华为搞不定大模型预训练,只能做推理。
老黄这话像是想劝特朗普尽快开放中国市场,捞钱。 可华为上周公布这些东西后,我信老黄是真心的。 他可能早就知道华为在研究这些技术,且进步飞快。 按已公布的纸面参数,华为已不虚英伟达。 单卡性能不够,万卡、百万卡来凑,最后拼的是有效算力。
就像韬定律一样,真正颠覆性的创新?好像没有。 但每个细节多抠一抠,照样能发挥难以忽视的威力。 现在拦路虎只剩两个:怎么提高量产,以及CANN何时取代CUDA。 这两件事,一时半会儿解决不了。 前者要等国产光刻机,后者靠大家不断使用优化。
总归现在比刚开始用昇腾时好多了。 我们在WAIC上还看到,其他国产显卡厂商也在发力超节点,各有成果。 美国费半天劲,国产AI大模型争气好几个,算力系统也没被卡脖子。 这感觉,真爽。