国产算力里程碑!曦云GPU率先完成中国电信大模型Day0适配
国产算力圈传来重磅消息,沐曦股份的曦云C系列GPU率先完成中国电信新一代星辰大模型的Day 0适配。这意味着,新模型一发布就能直接在曦云硬件上跑起来,真正实现了“上线即适配”。这事儿发生在9月19日,当时中电信人工智能科技有限公司刚发布了星辰大模型Xing4.0-29B-A4B。
这款新模型可不是普通货色,它是专门给智能体时代量身定做的轻量级代码智能体大模型。技术上采用了MOE架构,总参数量达到29B,但实际激活的参数只有4B,既保证了性能又控制了开销。它还原生支持256K上下文,要是需要还能扩展到512K,处理长文本任务不在话下。
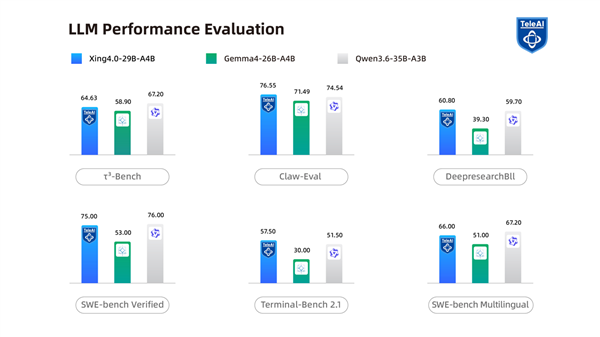
说白了,这模型是国内头一个完全靠国产算力和国产框架从头训出来的百亿参数大模型。它主要盯着复杂工程任务做优化,重点提升任务规划、工具调用和自主执行这几项硬核能力。简单说就是让AI能自己干活,不用人一直盯着。
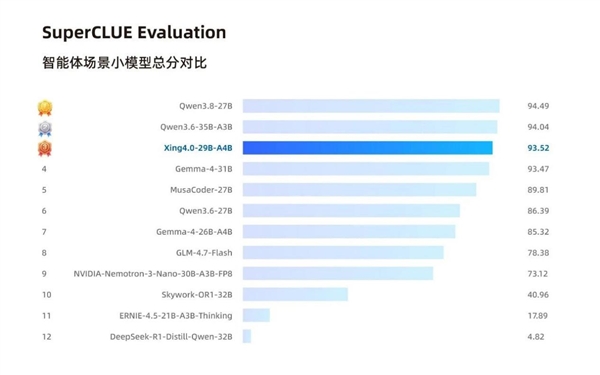
性能数据也挺能打。在SWE-bench Verified测试里拿了75.0分,Terminal-Bench 2.1拿到57.5分,这两个分数都超过了同样尺寸的竞争对手。在SuperCLUE智能体能力评测中,它以93.52分排在第三位,跟前面两个头部的Qwen模型差距不到1分,实力相当接近。
还有个实用细节值得提一提。这个模型做了4-bit量化之后,显存占用降到了15GB。啥概念呢?像RTX 3090、RTX 4090这种消费级显卡都能跑得动。也就是说,个人开发者或者小团队也能在本地部署使用,门槛低了不少。
沐曦这次能快速搞定适配,靠的是自家的MXMACA软件栈。这套系统覆盖了从底层驱动到MXCC编译器,再到算子深度适配和主流训练推理框架对接的全链条。最厉害的是,它能传统模型适配需要的几周时间,压缩到几个小时就搞定。
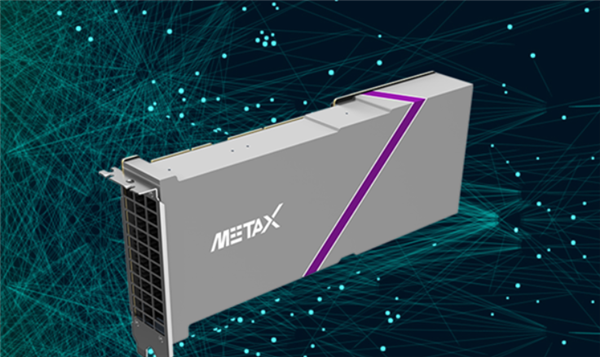
现在MXMACA已经兼容了40多种AI框架,适配过的模型超过1000款。对PyTorch 2.8的支持也很全面,2410个GPU算子全都支持。从2025年12月开始,沐曦已经完成了38个主流顶尖模型的Day 0适配,涉及智谱AI、阿里千问、MiniMax、DeepSeek、阶跃星辰、腾讯混元这些大厂的产品。
适配的速度、数量和生态覆盖面,都在行业里排得上号。