高通第六代骁龙8至尊版集成全新NPU:专为AI智能体打造
高通最近在官网上悄悄放出了一颗重磅炸弹,那就是全新一代的Hexagon NPU。这颗芯片可不是普通升级,它是专门为下一代AI智能体量身定做的。简单来说,就是为了让手机里的AI助手变得更聪明、反应更快,还能在本地搞定复杂任务。
这次高通第六代骁龙8至尊版系列带来了两大核心变化。一个是全新的Element Accelerator,另一个则是更大容量的共享内存系统。这两项技术联手,直接把端侧AI的性能天花板给抬高了。以前手机上跑大模型总卡脖子,现在终于有了新解法。
Element Accelerator的设计目标非常明确,就是冲着Transformer工作负载去的。它把向量计算单元和标量计算单元结合在一起,专门加速大模型里最核心的运算环节。这样一来,智能体响应速度能明显提升,推理过程也更高效。
关键是,这一切都是在保证手机功耗可控的前提下实现的,用户体验自然更丰富。 再来看那个更大的共享内存系统。高通把多模型状态、上下文信息还有KV-cache数据,全都挪到了离加速器更近的地方。这个操作直接缓解了内存瓶颈问题。
说白了,就是让智能体在处理超长对话、调用一堆工具或者同时干好几件事的时候,依然能保持丝滑流畅,不会动不动就卡顿。 这些技术创新加在一起,重新定义了Hexagon NPU的角色定位。它的使命就是在终端侧直接运行更多的智能体AI体验。
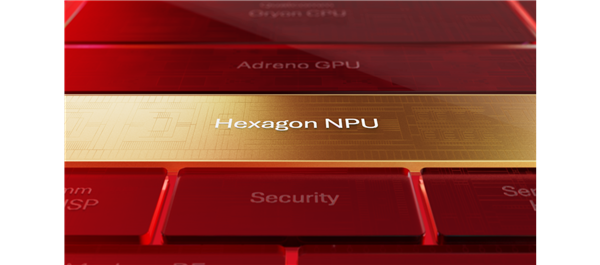
Element Accelerator加上向量与标量扩展单元,再加上更大的共享内存,三者组成了一套协同作战的架构。这套组合拳既能加速Transformer运算,又能搞定那些控制逻辑特别复杂的智能体任务。
而且,高通还特意强调,这颗NPU是面向下一代模型架构设计的。他们正在跟主流的内存和模型厂商深度合作,打算把混合专家模型也就是MoE引入到新的端侧AI架构里。这可不是小打小闹,而是对整个移动AI生态的一次重构尝试。
举个具体的例子,一个拥有300亿参数的MoE模型,虽然整体规模庞大,但在NPU上每次生成一个词元时,只需要激活大约30亿个被路由选中的参数。剩下的几百亿参数可以暂时闲着,既省资源又不耽误事。这种设计思路相当巧妙,平衡了性能和成本之间的关系。
这就引出了MoE和传统密集模型的最大区别。密集模型每次推理都得动用大部分网络,算力消耗巨大。而MoE则像个聪明的调度员,会根据具体输入动态挑选合适的专家网络来干活。这样不仅减少了实际的计算负担,也降低了内存带宽的需求,让手机芯片能喘口气。
最后还得提一下配套的技术手段。高通采用了智能的专家模块从闪存到内存的加载管理机制,还搭配了先进的缓存技术。这套玩法能在低功耗和低内存占用的情况下,跑出接近超大模型的AI效果。最终落到用户手里,就是一台反应迅速、又注重隐私保护的智能手机,随时随地都能享受高质量的生成式AI服务。