曙光8000十万卡集群落地:浸没式相变液冷成关键
中科曙光近日宣布,国内首个全国产十万卡AI超算集群正式落地。这个叫曙光8000的系统,核心亮点在于采用了浸没式相变液冷方案,直接对准超大算力集群最头疼的散热问题。说白了,就是给十万张卡找个靠谱的降温办法。
AI加速卡一旦堆到十万卡级别,芯片发热量蹭蹭往上涨。传统的吹风机式风冷或者贴个冷板的法子,已经快玩不转了。温度一高,芯片就得降频干活,整个集群也不稳定。这时候,液冷就成了让国产高算力芯片满血运行的救命稻草。
这套浸没式相变液冷怎么弄?简单讲,就是把计算卡、主板这些核心部件,整个泡进绝缘冷却液里。液体受热后沸腾,发生相变,热量就被迅速带跑了,然后形成一个闭环循环,持续交换热量。这招比老派的风冷强多了。 跟传统风冷比起来,这套方案的散热密度明显提升。
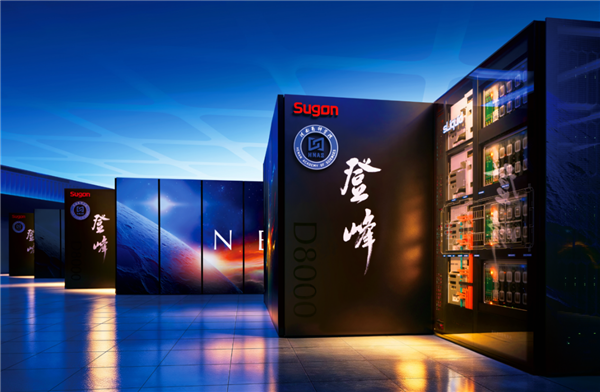
机房占地面积能省不少,整机能耗还能砍掉大约四成。最亮眼的是集群PUE值,能低到1.04。这意味着在十万卡高密度部署的压力下,温控依然稳得住,大模型长时间训练也不会因为过热而慢下来。 曙光8000不光散热牛,还实现了从芯片、计算、存储到高速网络的全链路国产自主可控。
它用的是超智融合架构,既能扛住AI大模型的训练和推理,也能搞定高精度的科学计算任务,一专多能。 系统里搭载了自研的scaleFabric高速网络和分布式存储,专门为了支撑十万卡规模下的大规模并行通信。
现在,它已经接入了国家超算互联网,能适配新材料研发、生物医药研究、气象仿真这些AI for Science的实际场景。 这次集群落地,不光证明了国产算力硬件能搞大规模协同,也验证了自研的浸没相变液冷技术,确实撑得起十万卡级的超级工程。
在算力需求疯涨的今天,液冷已经不是选不选的问题,而是国产超大规模AI集群能不能跑起来的基建底座。