小米开源380亿参数具身模型,速度提83倍拿榜首
今天有个大动作,小米正式发布了Xiaomi-Robotics-U0。这玩意儿是个380亿参数的多模态自回归模型,而且直接全量开源。说白了,它是行业里第一个能统一搞定四类核心具身生成任务的方案。 以前做机器人,场景、轨迹、视频的生成模型都是各干各的,互相不通气。
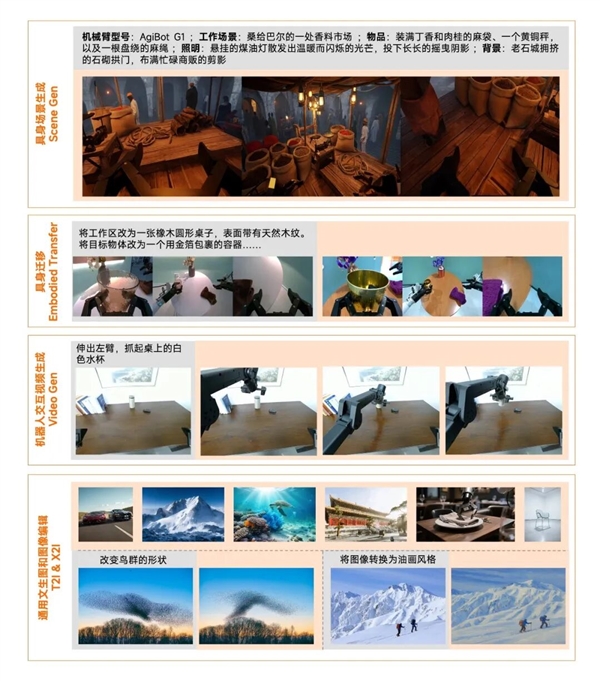
现在这个新模型把这一堆事儿给整合了。它能自己生成和扩增机器人训练用的图像和视频数据。这下好了,那些真机采集起来特别麻烦、成本还高的极端、危险、长尾场景,终于有了低成本的解决办法。 这事儿的关键在于速度。
小米靠着自己研发的FlashAR+推理加速方案,把生成效率比传统自回归架构提升了将近83倍。这个数字很夸张,意味着大规模生产具身数据的门槛被大大降低了。 具体能干啥?这模型一口气承载了四个核心能力:具身场景生成、具身轨迹迁移、机器人交互视频生成,还有通用的文生图和图像编辑。
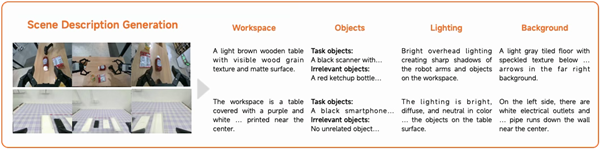
它用了个独创的五维解耦结构化控制范式,能把工作台布局、操作物体、杂物、光照、背景这五个维度拆开,用自然语言单独调。 这里头有个细节值得注意。不管怎么改画面元素,都能保证多视角的几何一致性。也就是说,不会突然出现机械臂位姿错位或者场景空间畸变这种尴尬情况。
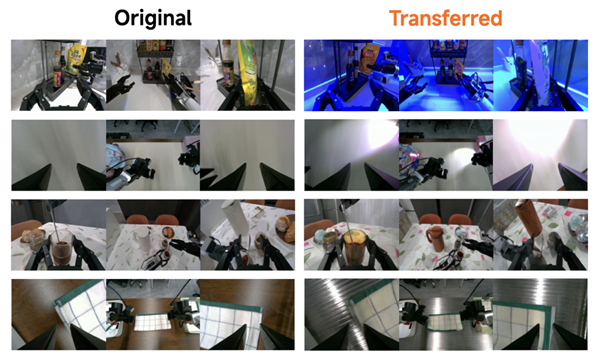
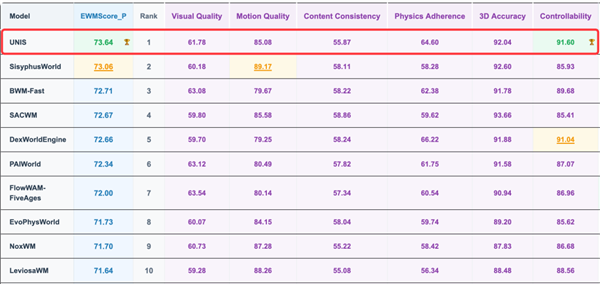
兼容性方面也挺广,方舟无限、智元多款、松灵PiPER这些机器人本体都支持。生成的环境更是五花八门,室内、户外、海底、赛博风,各种开放世界仿真环境都能搞。 效果到底怎么样?咱们看数据。在全球126款模型一起比的WorldArena具身视频评测基准里,Xiaomi-Robotics-U0拿了总分第一。
指令遵循、交互流畅度、多视角一致性,这几项全是领跑状态。 再说说跟闭源模型的对比。在具身迁移测试中,它在深度一致性、结构保真这些指标上全面超越了GPT-Image-2.0。那个闭源模型有个通病,就是跨视图物体容易错位,根本没法拿来扩机器人训练数据。
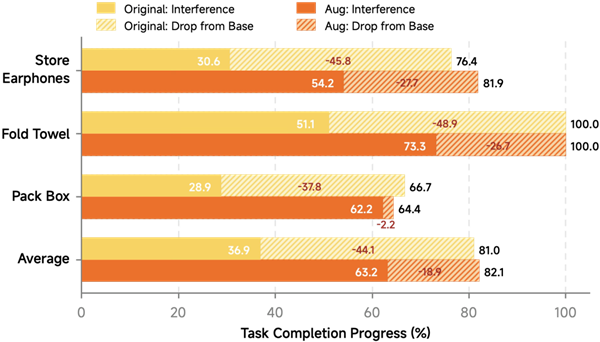
这次小米的方案明显更靠谱。 真机实测更有说服力。用这个模型扩增数据去训练机器人,在陌生光照、全新背景这种没见过的复杂工况下,任务完成进度平均提升了超过26%。就算遇到反光、彩色强光这些视觉干扰,机器人也能自己校正过来。
环境泛化能力提升了一大截。 最后聊聊推理速度这块的技术细节。小米推出的FlashAR+加速方案,配合vLLM分页KV缓存批量调度技术,专门优化了图像编辑和具身迁移的全流程解码速度。1024*1024分辨率的图像生成,耗时从原来的四百多秒直接压到了5.44秒。
既保证了画面质量和物理交互的真实性,又能满足工业化批量生成的需求。 目前,这个模型的全部代码和权重已经在官网、GitHub、Hugging Face以及魔搭平台上完整开源了。全球具身智能开发者都可以免费拿去用。