麒麟2026芯片实测:晶体管密度飙升55%,GPU功耗直降58%
9月4日,华为半导体业务部总裁何庭波围绕"韬定律"发表的学术论文迎来了新一轮修订。
本次更新的核心内容聚焦于业界高度关注的LogicFolding(逻辑折叠)技术在功耗及温控方面的表现,同时首次公布了麒麟2026芯片的多项实际测量指标。
文中明确反驳了一种普遍认知——即有源晶体管的垂直堆叠必然导致单位面积功率密度和热量输出攀升。然而麒麟2026的实测数据给出了截然相反的结论。
数据显示,麒麟2026在晶体管密度增长55%的前提下,同等性能水平下NPU能耗削减66%、GPU能耗削减58%、CPU高性能核心能耗削减41%。
从技术细节而言,麒麟2026是全球首颗搭载LogicFolding架构的移动处理器,其晶体管密度从前代的每平方毫米约1.55亿颗跃升至2.38亿颗,单代增幅达55%。
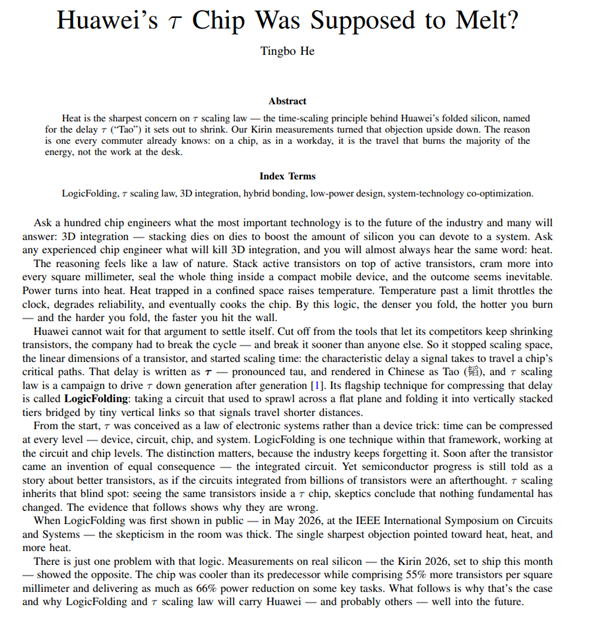
论文表示,仅一代产品所实现的密度跨越,便等同于过去依赖传统几何微缩技术连续推进三年度过的积累。
而在能效层面,LogicFolding的优势表现得更为突出。
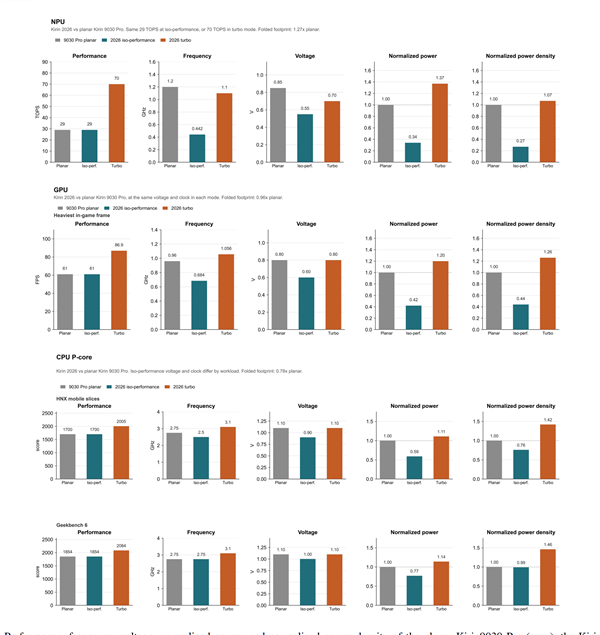
当麒麟2026与麒麟9030 Pro维持一致的计算性能时,NPU在稳定输出29 TOPS算力的工况下,运行主频可下调63%,供电电压从0.85V压低至0.55V,综合能耗随之减少66%,功率密度更是缩减了73%。
GPU方面,在双方均锁定61帧画面输出的场景中,麒麟2026的工作电压较麒麟9030 Pro低了200毫伏,对应能耗降幅为58%。
CPU高性能核心则在HNX基准测试中,凭借低9%的主频和低200毫伏的电压即可匹配前代同等表现,能耗相应下降41%。
若将目标转向极致性能释放,LogicFolding同样能打开更高的天花板。
论文中的压力测试表明,开启Turbo模式后,麒麟2026 NPU峰值算力可达70 TOPS,较前代飙升141%;GPU帧率最高可提升42%;CPU在HNX项目中的得分最高增长18%。
一个自然的疑问随之而来:晶体管密度大幅攀升,功耗为何不升反降?
何庭波在文中给出的根本性解释是:当代芯片中相当大比例的能源消耗并不产生于晶体管自身的运算过程,而源于数据与信号在芯片内部各区域间的搬运。
LogicFolding的做法是将原先沿平面方向铺展的远距离连线,转化为相邻层级之间极短的垂直通路,由此大幅压缩信号传播距离,进而削减互连寄生电容及其带来的额外耗能。
实测结果表明,经折叠处理后,典型核心区域的布线总长度平均缩短20%,个别关键路径最长可压缩70%;某特定处理单元的时钟网络布线减少了28%,所需时钟缓冲器也从43600枚精简至19000枚。
制造工艺维度上,麒麟2026采用了1.5微米混合键合间距,集成约5000万根垂直互联通道,其中10%到15%承担信号传递任务。
论文还前瞻性地披露,麒麟2027的验证用硅片已将混合键合间距压缩到1微米,垂直互联总数突破1亿根;未来三年内,该间距还将继续收窄至720纳米,垂直互联规模预计超过2亿根。
值得注意的是,论文同时提醒,LogicFolding并不等于堆叠结构天然就具备低功耗优势。
麒麟2026之所以能取得如此显著的能耗改善,关键在于华为主动将LogicFolding所创造的性能与时序裕量转化为降压降功耗的空间;倘若反过来把全部冗余都用来拉高频率和性能,其功率密度完全有可能反超前代产品。
现阶段,麒麟2026对LogicFolding的使用策略仍较为审慎,主要面向收益显著的关键路径实施定向折叠,并结合热感知的版图规划,防止高热耗模块在垂直方向上正面对齐。
此外,论文提及麒麟2026 CPU高性能核心的主频已触及3.1 GHz,并预判在未来三到五年内,LogicFolding仍有充裕的优化余地,麒麟CPU核心频率有望冲击5 GHz乃至更高层次。
相较于早前版本对"韬定律"理论框架与技术路线的描述,本轮修订最引人注目的变化在于:麒麟2026终于亮出了NPU、GPU、CPU三大核心单元的真实跑分数据。
尤其是在晶体管密度增长55%的背景下,GPU能耗下降58%、NPU能耗下降66%,正面回答了三维逻辑折叠领域最受质疑的功耗与散热难题。