高通搞出内存新架构:带宽翻54倍,还不烫手
AI算力现在涨得飞快,可麻烦也跟着来了。最头疼的就是那个“内存墙”,说白了就是内存带宽跑不过算力需求。就算用上HBM这种高带宽内存,也常常捉襟见肘,而且发热量越来越大,让人头疼。 高通最近坐不住了,直接在投资者日上亮出了新家伙——一个叫“HBC”的高带宽计算近内存架构。
这玩意儿的目标很明确,就是要打破内存墙的束缚,让特定的AI负载能实现性能的线性提升,不再被瓶颈卡脖子。 HBC的设计思路其实挺简单粗暴。它直接把AI加速器从SoC系统芯片里拆出来,然后像盖楼一样,把它堆叠在LPDDR内存堆栈的下边。
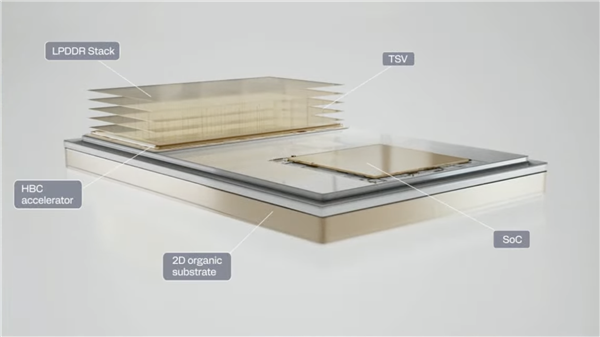
两者之间通过TSV硅通孔直接相连,省去了中间那些弯弯绕绕的步骤。 这么一改,好处立马就出来了。延迟直接被压到了SRAM那个级别,速度嗖嗖的。同时,它还保留了堆叠内存那种高密度、大容量的优势。最关键的是,它成功避开了HBM那套复杂的封装工艺,不用搞昂贵的硅中介层,设计和成本的压力都小了不少。
当然,话不能说的太满。论绝对的带宽和容量,HBC确实比不过HBM,高通也没敢公布具体的数值。他们只是透露了一个比例,那就是单位功耗下的带宽,是HBM的5到7倍;至于容量嘛,那是片上SRAM的200倍以上,这差距还是挺明显的。
这事儿有个有意思的地方,高通的这个思路并不是凭空想出来的“原创”。实际上,不少存储厂商早就盯着近内存计算架构研究了,只不过大家一直没能真正大规模落地应用,算是行业里的老大难问题。 举个例子,ASIC厂商智邦集成电路最近也搞了个叫DRAM-on-Logic的技术。
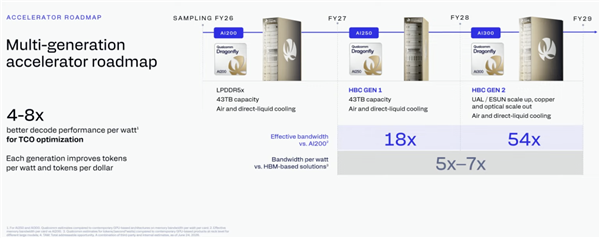
他们在逻辑芯片上堆叠了1到4层DRAM,带宽能达到大约5TB每秒,有些场景下性能甚至比部分HBM3E还要强,看来大家都在往这个方向使劲儿。 再看高通自家的产品线规划,节奏排得很紧。今年的Dragonfly系列AI加速器要推出一款叫“AI200”的产品,它先搭配传统的LPDDR5X内存,容量最高能干到43TB,散热方式也很灵活,风冷水冷都能选。
等到明年,第一代HBC产品“AI250”就会登场。它的最大容量依然是43TB,但在有效带宽这块儿,相比去年的AI200,能直接提升18倍,进步相当可观。 再往后看一年,第二代HBC产品“AI300”将正式跟进。
虽然官方没明说具体容量是多少,但重点强调了扩展能力的增强。到时候,带宽相比AI200的提升幅度将达到惊人的54倍,这数字听着就让人热血沸腾。