Intel 18A-P试产:PPT标签撕掉,2nm双雄时代开启
当地时间2026年6月16日,美国夏威夷檀香山的2026年VLSI国际研讨会现场,Intel扔出了一颗重磅炸弹。18A系列首个性能增强版本18A-P,正式进入风险试产阶段。这事儿说白了,就是Intel把自己压箱底的家伙事儿亮出来了,而且进度跟去年对外承诺的时间表严丝合缝。
Intel代工执行副总裁兼总经理Naga Chandrasekaran在现场放话,这次展示的进展和报告,给客户和合作伙伴递了个明白话。Intel在前沿制程创新上,是长期坚定投入,没打算松手。这话听着像官方套话,但结合前几年的背景,分量完全不同。
过去好几年,Intel因为制程屡次跳票,被业内扣上了“PPT工艺”的帽子。意思是图纸画得漂亮,落地全是虚。这次不一样,Intel是真金白银砸进去,拿硬实力说话。半导体圈有条老规矩,敢启动风险试产,说明工艺真的成熟了。
啥叫风险试产?可不是实验室里摆弄几个样品,也不是小批量流片试试水。这是对自己工艺有十足底气,愿意砸下数十亿美元的产线资源,提前搞规模化晶圆生产。而且心里有底,这些造出来的芯片,最后能卖出去。 说白了,这就是Intel用自己的钱,给18A-P的良率、稳定性和综合性能做最强担保。
更关键的一点,18A-P从一开始就不是给自己家用的。它是Intel代工业务成立后,头一个专门为外部客户定制的2nm级主力制程。 这一动作,等于Intel彻底甩掉了“内部工厂”的附属身份。以前大家觉得Intel就是自己造车自己开,现在它有了能跟台积电在2nm市场上正面硬刚的拳头产品。
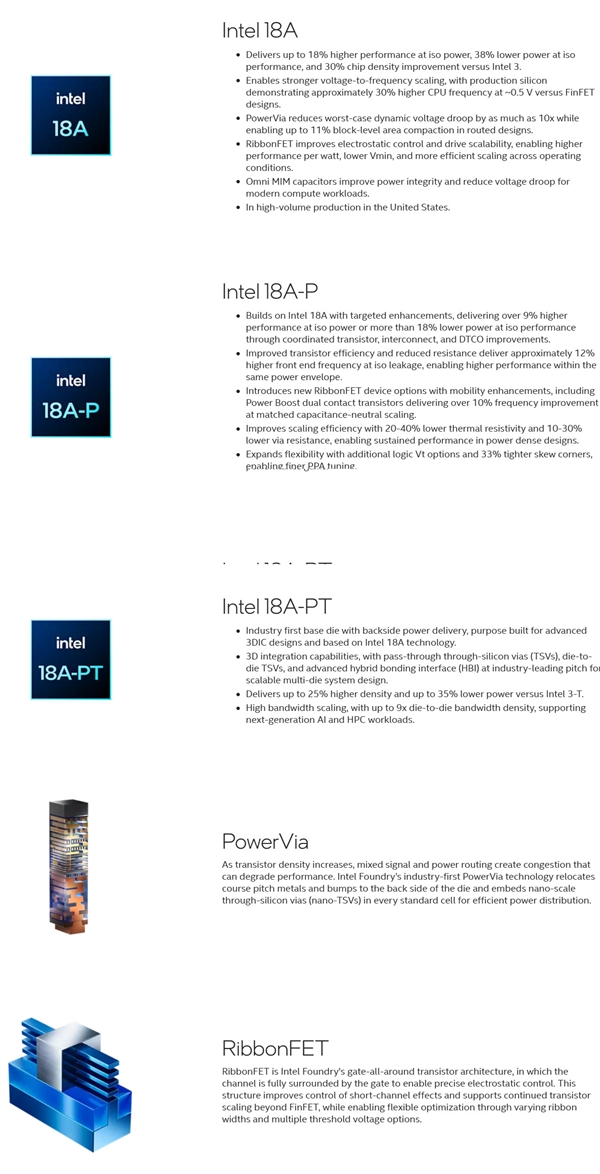
18A-P跟基础的18A到底差在哪?官方介绍里反复强调,18A-P是18A家族的第一个性能增强演进版。18A是地基,18A-P是在地基上加装的豪华包。核心性能往上提,新功能特性一大把。 它的PPA表现,也就是功耗、性能、面积的综合指标,竞争力很强。
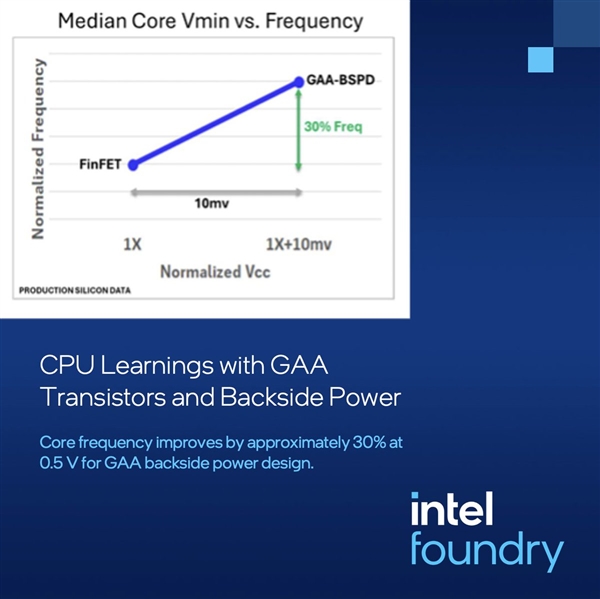
最关键的是,跟18A百分之百向后兼容。你在18A上做完的设计,直接搬到18A-P上用,不用大动干戈。18A里那些好用的设计端功能,全保留,可靠性也跟18A一个水平。 几乎零迁移成本的情况下,Intel靠晶体管、互连和设计技术的协同优化,搞出了九大技术进展。
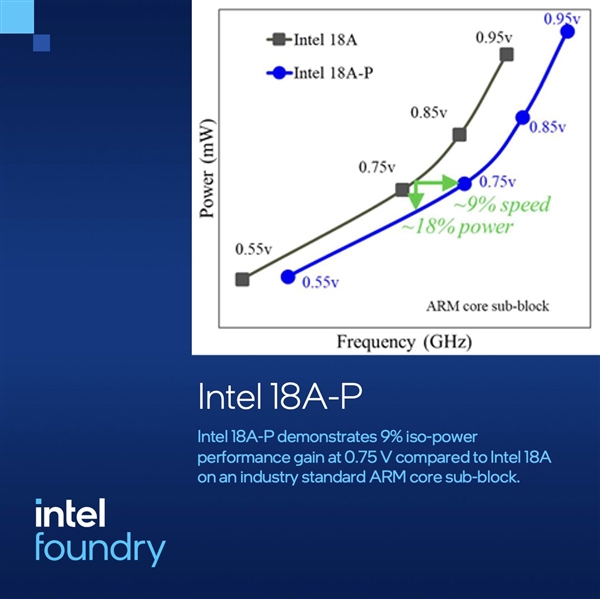
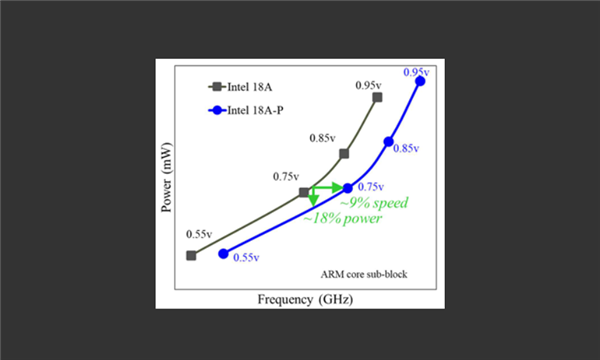
第一条,核心PPA指标全面飞跃。跟基础版18A比,同样功耗下性能提9%,或者同样性能下功耗降18%。热特性也增强了,芯片设计的灵活性大了不少。 这个提升覆盖了0.55V到0.95V的全部工作电压区间。
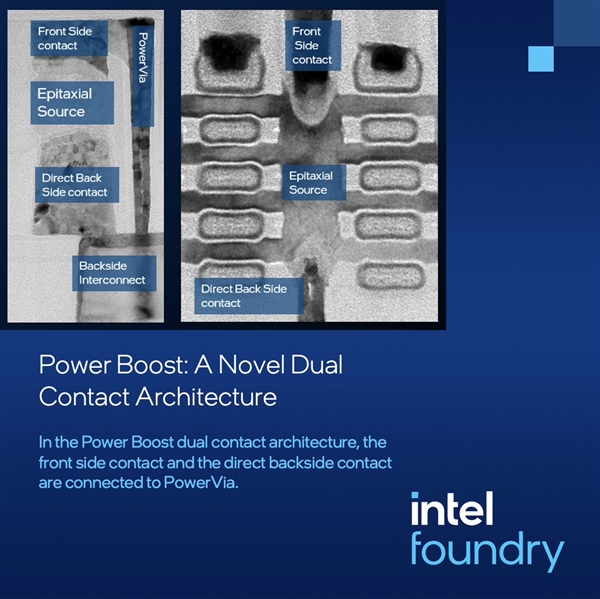
不管是想省电池的电芯,还是满负荷跑的AI芯片,都能吃到同样的红利。第二条,新增PowerBoost能效增强技术。这是18A-P最核心的差异化创新,用了全新的双接触、低电阻晶体管方案。 在电容中性的前提下,频率能提超10%。
这次性能提升的大头,就来自这里。第三条,热阻大幅降低20%到40%。靠材料和设计的双重创新,Intel把先进制程常见的散热难题给解了。对于几百瓦功耗的AI加速芯片,散热好不好,直接决定能不能一直跑在最高频。
第四条,过孔电阻降低10%到30%。通过几何结构精细化优化和新型导电材料,芯片各层之间的垂直连接过孔电阻明显下来了。信号传输延迟短了,互连过程中的能量损耗少了,整体能效比跟着涨。 第五条,通过应变工程提升PMOS迁移率。
Intel在晶体管制造时引入精准可控的应力,改变硅晶体的晶格结构。空穴能更高效地穿过PMOS晶体管,电路运行速度直接加快。第六条,新增低功耗与高性能晶体管选项。 Intel扩展了RibbonFET器件版图,引入带迁移率增强的全新器件选项。
不同需求的应用,有了更丰富的选择。第七条,新增第五组逻辑阈值电压选项。在原来的超低阈值电压和低阈值电压之间,加了个中间档。 芯片设计人员多了个平衡速度和功耗的选择,PPA调优空间更细了,同批次芯片的性能一致性也高了。
第八条,18A-P跟18A的设计规则完全兼容,现有的IP和设计流程能方便复用。第九条,18A-P保留跟18A一样的单元库规格。提供180nm和160nm两种单元高度,接触栅极间距保持50nm不变。 这保证了设计无缝迁移,客户的切换成本和风险都低了。
18A家族是个完整的技术谱系,不是单一节点。除了已量产的基础版18A和风险试产的18A-P,Intel还规划了专门面向下一代AI和HPC的18A-PT节点。 基础版18A已经在全面量产爬坡,主要用在第三代酷睿Ultra处理器、第三代酷睿处理器和至强6+处理器这些Intel自家产品上。
它是全球首个同时量产RibbonFET全环绕栅极晶体管和PowerVia背面供电技术的节点。跟Intel 3制程比,每瓦性能最高提15%,芯片密度提30%。 18A-P是面向通用市场的性能增强版,主打极致PPA和零迁移成本,适合大多数外部代工客户。
18A-PT则是业界首个带背面供电的3DIC专用基础裸片工艺,专为复杂多芯片系统打造。它在18A-P基础上,加了三大核心能力。 第一,完整的3D集成能力。支持直通硅通孔、裸片间硅通孔,还有业界领先间距的先进混合键合接口,能让多裸片高密度堆叠。
第二,密度更高、功耗更低。跟Intel 3-T制程比,密度最高提25%,功耗降35%。第三,超高带宽扩展。 裸片间带宽密度最高是Intel 3-T的9倍,下一代AI训练芯片和高性能计算芯片的海量数据传输需求,完全能满足。
从通用计算到AI加速,从单芯片到复杂3D集成,18A家族形成了完整矩阵,覆盖几乎所有高端芯片场景。 这还没完,Intel 14A,也就是18A之后的下一代节点,预计2028年风险试产,2029年大规模量产。
Intel 14A会用高数值孔径EUV光刻机制造,采用第二代RibbonFET全环绕栅极晶体管,加上PowerDirect直接背面触点供电技术。 Intel 14A还会引入Turbo Cells增强型标准单元技术,跟RibbonFET 2配合,能再提芯片速度,比如CPU最高频率和GPU关键路径性能。
Turbo Cells让设计人员在同一模块里灵活组合高性能和高能效单元,按应用需求精准平衡功耗、性能和面积。 Intel 14A的0.5版本PDK已经发布,计划2026年10月对外发0.9版本,内部客户先拿到。
目前已经有好几个客户对Intel 14A感兴趣,正商量具体产品、代工厂选址和产能需求。技术底牌方面,18A到底是啥水平?答案是业界公认的2nm级制程。 现在的制程数字不代表晶体管实际物理尺寸,只是个行业迭代的标尺,衡量晶体管密度和综合性能的提升幅度。
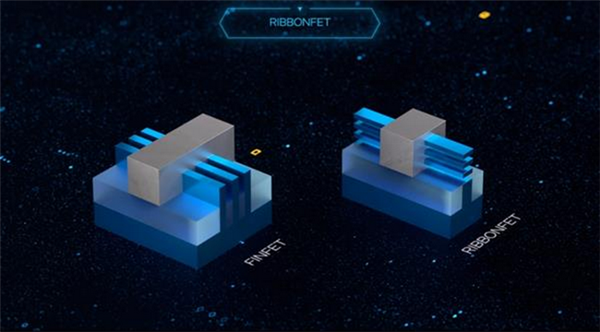
18A就是Intel对标台积电N2、三星SF2的2nm级主力节点,靠两个核心技术撑场子。第一个是RibbonFET全环绕栅极晶体管。 看对比图,左边传统FinFET晶体管,是一条条立起来的硅鳍片,栅极只能从三面跨上去控制电流,总有一面漏着。
右边RibbonFET,把鳍片切成四条平行超薄纳米带,栅极从四面八方全包住了。这种全环绕结构能彻底掐断漏电,晶体管开关更准。 Intel独有的四条纳米带设计,好比把三根水管换成四根,相同面积下能过更大电流,开关更快,算力更强。
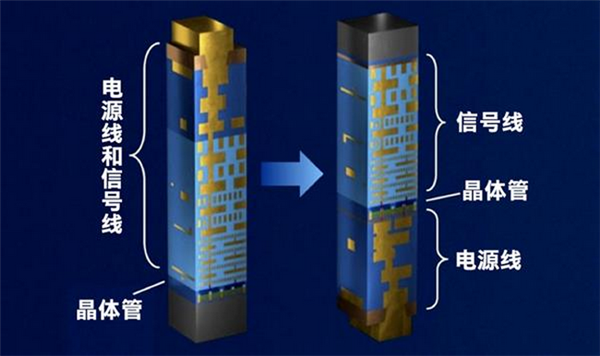
通过调纳米带宽度和阈值电压类型,能从智能手表用到超级计算机。第二个是全球首个量产的PowerVia背面供电技术,这是过去三十年芯片供电最颠覆的变革。 现在越来越多场景需要更小、密度更高、性能更强的晶体管,混合信号线和电源一直在抢晶圆内同一块空间,导致拥堵,给晶体管微缩添堵。
看图,左边传统芯片,电源线和信号线全挤在晶体管上方,粗笨电源线占大半地方,信号线堵了、互相干扰,线路长还电压损耗大。 右边PowerVia架构,把所有电源线搬到晶体管下方晶圆背面,通过纳米级硅通孔,直接送电到每个晶体管底部。
这项技术让芯片密度和标准单元利用率提5%到10%,供电路径电阻和电压降显著降低,还能带来最高约4%的等功耗性能提升。 垄断终结,2nm代工市场进入双雄时代。18A-P风险试产,改的不只是Intel的命运,全球2nm级制程竞争格局也被重写。
之前这市场基本是台积电独角戏,N2产能被全球头部客户锁到2028年。三星SF2因为良率问题,迟迟形不成有效竞争。全球芯片公司,尤其是急缺产能的AI厂商,被产能卡得难受。 现在,有个真正能打的第二供应商了。
跟台积电比,Intel有三个差异化优势。第一,美国本土制造。18A系列全在亚利桑那州和俄勒冈州的晶圆厂生产,能拿美国政府芯片法案全额补贴,还能满足美国本土企业对供应链安全的要求。这对美国科技巨头来说,吸引力致命。
第二,全栈代工能力。Intel不光卖制程工艺,还有EMIB、Foveros等全套业界领先的先进封装技术。能提供从设计、制造到封装、测试的一站式服务,这是目前任何纯代工厂都给不了的完整能力。第三,完整的衍生节点规划。
从通用型18A-P到3D集成专用的18A-PT,针对不同场景提供精准方案,满足多样化需求。 目前,18A-P已获得多家全球头部科技公司认可,多个合作项目在稳步推进。对整个半导体行业来说,18A-P的意义远超一个新工艺的诞生。
它打破了先进制程一家独大的垄断,给了全球芯片公司更多选择,也给爆发式增长的AI产业更多产能保障。 更重要的是,它证明了一件事。那个曾引领半导体行业几十年的Intel,从来没停下创新的脚步。过去几年的低谷,只是暂时调整和蓄力。
随着18A-P量产爬坡和18A-PT稳步推进,全球先进制程的战争,才真正进入白热化阶段。