阿里云推出新一代自研存储系统,百万卡级AI集群存储成本直降69%
2026年云栖大会期间,阿里云发布了一款专为下一代人工智能训练集群打造的新型高性能并行文件存储系统——新一代CPFS(Cloud Parallel File System)。
这款存储方案能够输出数百TB/s级别的吞吐量以及上亿次每秒的IOPS,单个文件系统的容量上限较前代扩大五倍,达到100PiB,旨在为百万张GPU卡规模的模型训练提速,满足超大规模预训练及多模态数据处理的严苛需求。
从实际部署效果来看,模型冷启动的平均等待时间缩短了一半,GPU峰值算力利用率提高了三成,AI相关存储开销削减了将近七成,整体业务吞吐量实现翻倍。
当前,大模型训练正迈入全面规模化时代。训练语料不再局限于纯文本,而是向图像、视频、音频等多模态方向延伸,数据体量可能膨胀五十乃至一百倍;与此同时,模型参数量大约增长了十倍,中间检查点(Checkpoint)的保存频次也显著增加。大量小文件的并发读取以及Checkpoint带来的瞬时写入洪峰,正在成为制约训练效率的新短板。一旦存储侧跟不上节奏,价值高昂的GPU阵列就会因为"喂不饱"而被迫闲置。
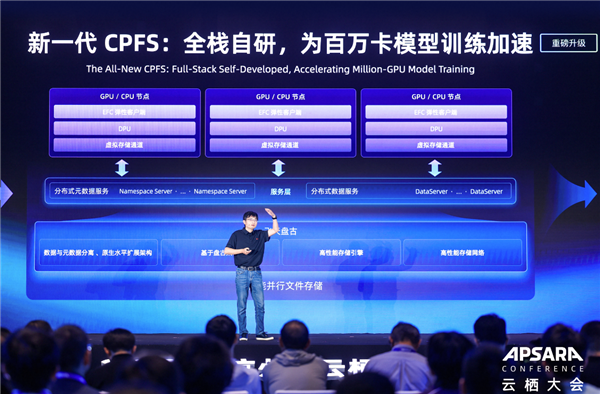
为此,新一代CPFS引入了数据平面与元数据平面解耦的设计思路,使容量与性能均可独立横向扩展。GPU节点和CPU节点借助EFC弹性客户端及虚拟存储通道,分别对接分布式的元数据服务和数据服务;底层则依托飞天盘古的分布式持久化存储引擎与高速存储互联网络,构建了涵盖客户端、协议解析直至数据最终落盘的完整自主研发技术栈。
具体指标方面,新一代CPFS的文件系统总容量提升了五倍,元数据操作性能提升了十倍,可管理的文件总数上限扩大了整整一百倍。单一文件系统可拓展至百PiB量级,并支撑万亿级别的文件对象。这意味着企业在不同训练阶段不必再对数据进行反复切割或搬迁,就能在同一套文件系统内统一管理训练语料、模型权重、Checkpoint快照及各类实验产出,并且可以跟随GPU集群的扩容同步提升容量与带宽。
面对冷热数据长期共存所引发的成本难题,CPFS还内置了智能化的生命周期调度机制与冷热分级存储策略,让不同访问热度等级的数据自动流向最匹配的介质层级,在确保训练性能不受影响的前提下,综合存储支出最多可压缩百分之六十九。
以通义千问(Qwen)大模型的训练实践为例,切换至新一代CPFS之后,模型加载阶段的平均耗时减少了一半,GPU峰值利用率提升了三十个百分点,平台可承载的业务规模直接翻了一番。
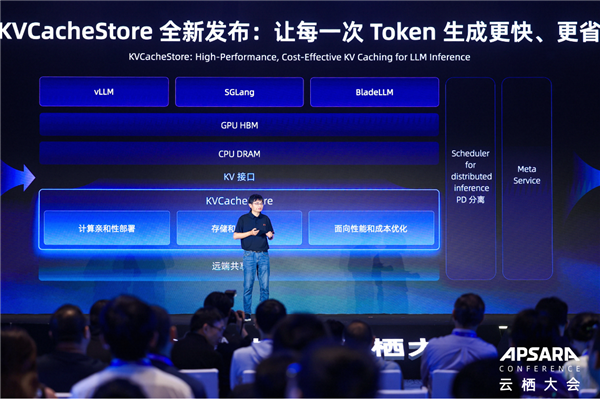
在大模型推理场景下,阿里云同步上线了名为KVCacheStore的KV缓存加速引擎。该组件部署于GPU片上显存、服务器主存与远程共享存储三者之间的位置,是一种基于靠近计算节点部署、高带宽网络以及弹性共享存储构建的全新G3.5层存储架构,核心理念是"用存储空间换取计算资源",用以消化长序列推理、多轮交互以及复杂智能体(Agent)工作流所产生的海量键值缓存。
KVCacheStore支持按算力拓扑进行亲和性放置,单个计算节点的读写带宽可达40GB/s,借助批量(Batch)接口能够支撑百万级QPS请求,单实例即可覆盖千亿参数级别的KV数据存储需求,经实测验证,缓存命中概率提升了二十个百分点以上。
"每经历一次模型能力的代际跨越,恰恰也是云存储体系进行自我迭代升级的最佳窗口期。"阿里云存储产品线负责人蒋江伟指出,未来阿里云将继续推动算力、网络与存储三者的深度融合创新,让数据以更低的延迟流入计算单元,让每一块GPU都被充分压榨,从而为大模型训练和各类AI落地应用筑牢一个兼具高性能、强弹性和持续降本能力的存储根基。