Jev 让全球程序员玩疯了
智能家居平台 Home Assistant 的社区近期冒出了一个叫 HA-Jev 的小插件。
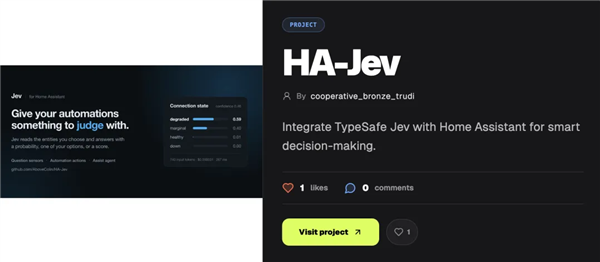
原理异常直白:传感器监测洗衣机电流波动以及舱门开合状态,随后将一个问题丢给模型——"洗衣机停转了,衣物是否仍搁在里面?"模型不产出任何自然语言解析,仅吐出一个数值概率。一旦该概率突破 0.8 的门槛,用户的手机便会收到一条取衣通知。
HA-Jev 唯一的功能就是提醒用户别忘了把晾好的衣服从滚筒里拿出来|图源:pitchhut
单次推理只需数十毫秒,开销仅为 0.000015 美元。
插件作者在社区论坛写下一句颇有余味的评论:"我从前总拿大语言模型去解答压根用不着它的问题。衣服有没有忘拿,这是一道判断题,不是一篇议论文。"
这番话精准戳中了当下生成式人工智能最尴尬的软肋。过去四年来,整个赛道将绝大部分算力预算、融资额度和工程师精力,统统倾注在"让模型学会说更像人话的内容"上。业界早已形成惯性:动辄调动数百亿乃至上千亿参数的巨兽,先输出一大段冗长的思维链,再用温文尔雅的日常用语包裹起来,最终还得靠开发者编写繁复的正则规则,从一堆废话里硬生生提取出那一个有用信息。
直到前 OpenAI 研究者 Diogo Almeida 携全新模型 Jev 横空出世。这款被冠以"System One"之名的模型没有"嘴",不产生任何文字,唯一的输出就是一组概率判定。
发布仅寥寥数日,全球开发者便围绕它孵化出将近五百个开源仓库。这或许是继 Openclaw 之后,最能点燃技术圈热情的新项目。
人们猛然意识到,一旦卸掉大模型那股非要把话说圆了的执念,原先笨重又烧钱的 AI 应用,竟能轻盈如疾风掠过。
**01 大模型的"突触"**
若将此前调用 GPT-5 或 Claude 的流程类比为高薪聘请一位无所不知的哲学家替你盯着监控画面,那么如今开发者借助 Jev 所做的,无异于在流水线上密布了大量成本低廉、响应极快的神经末梢。
在算力消耗最惊人的 Agent 基建层面,这种转变堪称范式级重构。
以往应对超长上下文,最通行的做法是请大模型做一轮摘要。开发者 Tamara Tran 另辟蹊径,开发了一款基于 Jev 的插件来缩减 Claude Code 的上下文窗口。它完全不做归纳提炼,而是逐条评估历史工具调用的关联程度,分数一旦跌破设定线,便将该条目整体丢弃。
借助 Jev 插件压缩 Claude Code 上下文|图源:X
效果令人瞠目:逼近一百万 token 的臃肿上下文,在一秒之内被裁减至 8.6 万,期间模型未输出哪怕一个字母。背后的道理其实很朴素——摘要是高成本的生成动作,而筛选不过是一次冷静的取舍。
同类型的破格实践同样出现在移动端自动化赛道。
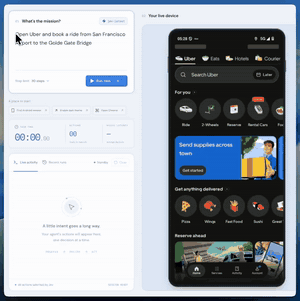
通过 mobile-jev 操控手机|图源:jevfast.com
Droidrun 团队打造了一款名叫 mobile-jev 的手机端操作代理。一段外泄的录屏显示,它驱动一台真实的安卓设备打开 Uber App,填入出发地与目的地,一路精确触控直达支付页面,九步操作总共只花了 21 秒。
整套链路从未触碰任何传统文本生成大模型,文字填充是从用户原始指令中截取的原样字符串,而每一步界面该点哪个坐标、该上滑还是该按确认键,统统交由 Jev 完成毫秒级的概率匹配。
不止局限于屏幕交互,开发者们甚至将它嵌入了最底层的基建组件。
GitHub 上迅速冒出 pg-jev 和 duckdb-jev 两个项目。开发者得以用日常口语,直接对数据库中的行记录执行实时的概率筛选与排序。Ruby 社区里,有人干脆把这种判断封装为原生的控制流关键字,写出来的代码仿佛赋予了程序一种本能直觉。
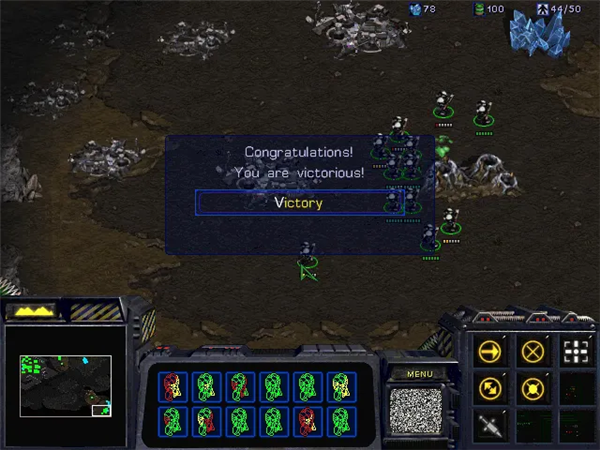
用 Jev 玩"星际争霸"已催生出一批 GitHub 项目|图源:Github
游戏圈也不甘落后。有人指挥 Jev 操控模拟器通关超级马里奥,有人让它扮演《毁灭战士》中的哨兵单位,更有小组将其接入《星际争霸》并成功完成了第一个交战任务。游戏要的是几十毫秒内的即时决断,以往的大模型尚在酝酿第一帧的行动方案时,虚拟角色早已倒在血泊中。
甚至,在数据清洗这种苦力型任务上,新旧方案的落差之大简直触目惊心。
一位开发者手里堆着三个月未处理的商品匹配记录,合计 9081 条。六月时他便用主流大模型估算过开销,高昂的 API 报价令他当场作罢。改用 Jev 之后,他花了一晚写出 150 行脚本,整个流程 13 分钟跑毕,最终账单定格在 32 美分。
当大模型不再刻意扮演一位博学的对话者,AI 才真正有机会渗透进自动化软件最细微的毛细管线。
**02 杰文斯悖论**
Jev 之名,源自 19 世纪英国经济学家威廉·斯坦利·杰文斯(William Stanley Jevons)。
经济学中广为人知的"杰文斯悖论"揭示了一条反直觉规律:当技术进步使某项资源的利用效率大幅提升、使用成本急剧下降时,该资源的总用量不仅不会萎缩,反而会呈指数级膨胀。
TypeSafe AI 为 Jev 设定的费率为每百万输入 token 收费 0.042 美元,输出端零费用。照此标准,即便每天执行一万次业务裁决,月度支出大约在 120 美元上下。而倘若沿用同等精度的旗舰推理大模型走一遍相同流程,每月的账单将飙升至 3.5 万美元。
断崖式的成本坍塌,立刻唤醒了那些曾被宣判"缺乏商业可行性"的边角用例。
用 Jev 做 SEO 优化的速度令人咋舌|图源:X
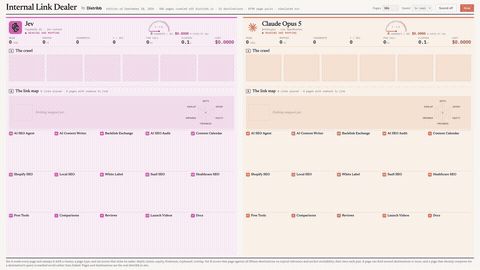
内容分析方向上,Distribb 的创始人利用 Jev 扫过了近六百个网页,45 秒内便完成了站内链接拓扑的全面重建,铺设了五百余条内链,总支出 21 美分。搁在从前,让顶级大模型干同样的活儿,这段时间恐怕连二十个页面都没读完。
这位创始人的感慨可谓一针见血:"这根本不是内容生产,不过是 8790 次'该不该建这条链'的二选一罢了。"
这也印证了为何 Diogo Almeida 在告别 OpenAI 时会发出那样的喟叹:"我们手握一道闪电,可它偏偏不好使。"
身为参与搭建 ChatGPT、共同开创 RLHF 训练范式的核心成员,Almeida 的反思透着一种身处风暴眼的冷峻。在他眼中,整个行业在"打磨人类自然语言"这条窄巷里兜圈子太久。
机器之间的协作根本不需要声情并茂的修辞,它们需要的是清晰指令加一组概率分布。过去四年 AI 领域砸下数千亿美元精心雕琢的语言能力,放在正经的系统工程语境下,多数时候反倒成了拖后腿的冗余。
Pi 框架 CTO Armin Ronacher 谈及此事时毫不含糊:"我们本该更早看清这一点。只不过先前主流大模型长期被风投资金补贴得近乎免费,所有人都养成了大手大脚的习惯,谁也不肯沉下心来做真正的架构创新。"
一旦这层廉价滤镜被击碎,架构层面的转向便再无回头路。
大模型,正在归位到它本来的生态位。
它不该充当中央处理器,它更胜任前端对外发声的角色。未来的系统蓝图里,海量毫秒级裁决将交给价格低廉如自来水的直觉型模型,唯有在确需向终端用户输出连贯段落、传递情感温度或撰写复杂长文的极少数关键节点,才会去唤醒那个造价高昂的生成引擎。
**03 "判断"与"生成"正式分庭**
复盘近三年 AI 领域的主流叙事,核心线索始终是"模型越做越大、越训越灵光、越包越全面"。一套模型既当聊天搭子,又兼程序员、图像分析师和数据表格工匠,样样通吃。整个行业心照不宣地把"智能"视为一整块不可切割的铁锭。
Jev 的问世,在这块铁锭上凿开了一道裂缝。它用事实证明:某些任务确实需要深度推理配合语言表达,而另一些任务只需要一次迅捷的概率裁定。将二者强行捆绑在同一套架构里,本质上是一种结构性的资源错配。