阿里全模态模型最新进展:Qwen4和下代视频模型均在训练中
9月22日,2026云栖大会正式拉开帷幕,阿里巴巴在会上披露了其大模型技术的最新突破与规划。
回溯来看,阿里早在2019年便启动了人工智能大模型的研发布局,此后逐步打造出千问Qwen大语言模型家族,以及万相Wan、HappyHorse等多条多模态模型产品线。
踏入2026年之后,阿里大模型的迭代步伐明显加快。仅在最近一个多月的窗口期内,Qwen3.8系列就连番更新了四款各具特色的模型及关键版本,整体性能与成本优势已跻身世界一流行列,成为当下企业用户及全球AI开发者社群中备受瞩目的国产模型之一。
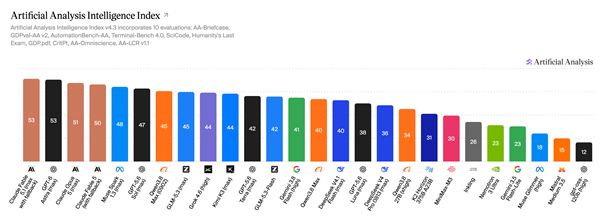
聚焦大语言模型赛道,Qwen3.8-Max在代码开发和协同办公两大场景中表现尤为亮眼,一经发布便在Artificial Analysis智能体评测中高居榜首,同时在CodeArena前端编程榜单上拿下第一名。此外,搭载新一代底层架构的Qwen4已经启动训练流程,未来Qwen4.5、Qwen5等迭代版本的参数量有望扩张至5万亿到10万亿的量级。
多模态方面同样成果丰硕。图像生成模型Qwen-Image-3.1的实力正逐步逼近当前最强大的GPT-Image系列,足以在全球范围内占据一席之地;语音模型Qwen-Audio-3.1则在自动语音识别、文本合成语音和实时语音交互三项核心指标上均达到国际第一梯队水准,稳居国内头名,性能已超越Gemini 3.1 TTS等国际标杆产品。
视频生成板块的演进同样引人注目。2025年推出的Wan2.6在国内率先实现了基于视频参考的生成能力,覆盖15秒时长并支持智能多镜头编排。到了2026年,阿里的视频模型继续向技术最前沿冲刺——今年4月问世的Wan2.7与HappyHorse1.0在影视级画面质感和视觉冲击力方面迈上了新台阶。
8月正式落地的Wan3.0更进一步,支持单条30秒视频的连续生成,兼容文档、表格、网页等结构化素材作为输入,并实现了原生的音视频同步输出,由此在Artificial Analysis的文生视频与视频编辑双重榜单上双双登顶全球第一。
值得一提的是,全新一代视频模型也定于11月揭晓,其演进方向指向更长的生成时长、更强的精细操控、更高的叙事完整性以及更深的智能理解:即便面对更长时间的连续生成,新模型依旧能够保持画面风格与逻辑的一致性,创作者得以对角色动作、场景氛围乃至镜头调度进行像素级的把控;与此同时,该模型还将具备接近专业导演的创作直觉,从单一镜头的生成跨越到对整段叙事的深度理解与构建。
在最新的Artificial Analysis全球大模型综合评分体系中,Qwen3.8-Max的综合得分已从先前的40分攀升至45分。