教ChatGPT说话的人做了哑巴模型 单次决策成本仅0.0004美元
AI圈里最懂如何让模型开口聊天的人,这次决定剥夺大模型的语言能力。 这位前OpenAI研究员、ChatGPT共同发明者Diogo Almeida,潜行两年后带着新公司TypeSafe AI和4000万美元融资重返牌桌。
他们发布的新模型Jev,不会写周报,也不陪用户深夜长聊,连标点符号都吐不出来。 这是一个反常识的时刻。过去三年,全行业都在教大模型学“慢思考”,各家实验室拼命拉长推理链条,让模型在给出答案前默默自言自语几千个词。
但Jev走了完全相反的路:它不做文本生成,只输出确定性的结构化决策。 这不仅是新产品发布,更像是对当前大模型技术范式的公然叫板。 要理解Jev到底是什么,得先看当下AI开发者的痛苦。 如今工程师把大模型接入业务系统时,常做着荒谬的事。
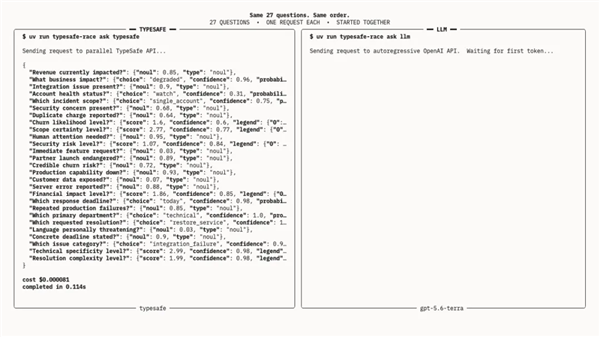
你只需它回答“这封邮件是不是垃圾邮件”,或“在五个API接口里选一个”。 但你不得不让一个拥有上千亿参数的庞然大物,在漫长几秒里,一个词一个词地把JSON字符串敲出来。 为保证字符符合代码规范,开发者得写满两页提示词,求着模型“别输出废话,只要纯JSON格式”。
即便如此,模型偶尔还是会加一句“好的,这是你要的格式”,瞬间搞崩下游整条流水线。 Jev解决问题的方式极其粗暴:它根本不是文本自回归模型。 在Kahneman著名的《思考,快与慢》中,人类思维分为两个系统。
系统一是无意识、极速的本能直觉;系统二是缓慢、需调动精力的逻辑推理。 当下主流大模型都在卷系统二,而Jev给自己定义为世界上第一个纯粹的“系统一模型”。 它不逐字生成内容,所有决策都在一次单向并行计算中同时产出。
这意味着没有生成式废话,输出永远严格锁定在开发者预先定义的Schema里。 在数学层面,Jev彻底消灭了结构化输出的格式幻觉。 由于不需一步步推演下一个token,其端到端延迟被压缩至70到500毫秒之间,比市面前沿大模型快了40到200倍。
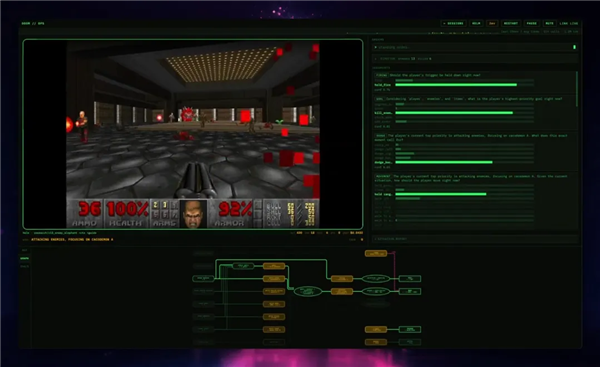
TypeSafe还拿Jev去玩射击游戏Doom。在无需复杂长线规划、只需每秒约10次即时操作判断的场景下,Jev表现得像反应极快的人类玩家。 整套推理成本每小时约7美元。更夸张的是价格:Jev输入成本每百万token仅需0.042美元,输出完全免费。
平均算下来,单次结构化决策成本约0.0004美元。作为对比,调用一次GPT-5.6 Terra的费用约为其76倍,Claude Opus 5则是数百倍。 输入非结构化数据,瞬间吐出带校准概率的分类选择、数值评分或布尔判断,然后立刻交出控制权。
这就是Jev的全部工作。 为什么TypeSafe选择在此刻做一个完全不吐字的模型?答案藏在正在全面铺开的AI Agent里。 无论是Cursor、GitHub Copilot还是硅谷企业级自动化工作流,工程师很快发现残酷现实:Agent又卡又贵,往往不是因为核心逻辑不聪明,而是中间“执行摩擦”太大。
一个完整Agent任务通常包含几十个微小决定。比如判断当前步骤是否成功、决定调用工具A还是B、提取上一段输出里的关键字段、判断要不要终止流程。 如果每个微小动作都调用一次千亿参数超大模型,延迟会层层累加到几十秒甚至几分钟,成本也会迅速失控。
更要命的是,任何一步JSON格式解析失败,整个Agent就会卡死在半路。 行业被自回归文本模型绑架太久,大家几乎默认所有AI任务都必须通过自然语言中转。 但现实世界的生产系统,绝大多数节点本质上是传统代码控制流。
代码不需要情绪价值,不需要排比句,只需要一个极度廉价、极其迅速、绝对符合类型的决策信号。 Jev的出现,是在大模型系统架构里插进一层“前置反射弧”。 在理想协同架构里,昂贵的前沿大模型应退居幕后,充当统领全局的系统二,负责宏观规划和高难度思考。
第一线处理脏活累活的,比如工单分类、内容合规初筛、大批量数据打标、在几十个API里精准选择调用哪一个,完全可以交给Jev这样的系统一模型毫秒级搞定。 TypeSafe自有测试数据显示,在四个典型企业工作流中,Jev准确率达67.8%,几乎打平GPT-5.6 Terra的67.9%。
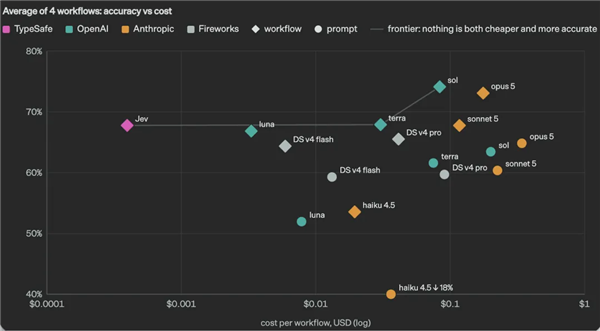
若只看判断精准度,它没输给贵数十倍的大模型,执行速度却拉开几十倍差距。 把大脑皮层慢思考与脊髓条件反射拆开,这或许才是AI Agent真正跑进大规模工业化落地的正确姿势。 不过,把Jev看作完美银弹显然过早。
这份惊艳技术答卷背面,至少有两块巨大阴影被刻意回避。 首先是可解释性全面丧失。 传统思维链模型虽啰嗦易错,但至少把“为什么这么选”的过程写在草稿纸上。当信贷审核Agent拒绝客户申请,或安全系统拦截一笔交易,合规部门可通过推理过程追溯决策逻辑。
而Jev输出只有干瘪选项和概率,不具备用自然语言阐述理由的能力。当模型做出关键误判时,没人能从黑盒权重里找出原因。 在金融、医疗、法律等强监管领域,这种缺乏审计能力的决策机制,往往会直接撞上合规南墙。
其次是技术细节与评估基准封闭。 TypeSafe宣称发明了名为RLCD的全新训练方法,取代传统RLHF。但从公开信息看,具体奖励函数设计、网络架构基础、校准概率数学方法论,官方均未披露。 更微妙的是那些漂亮分数。
目前所有基准测试均来自TypeSafe内部评估,无任何第三方独立机构复现。 他们用作真值标准的参考答案,是由GPT-6 Astra和Claude Fable 5.1跑出取平均值得到的。用竞争对手下一代模型当裁判,再宣布自己在性价比上大获全胜,这种自证闭环本身带着强烈公关色彩。
更不用说商业模式可持续性。每百万token仅收4美分,输出完全免费,价格低到让人怀疑是在烧4000万美元融资打价格战。 目前Jev仍处于小范围邀请内测阶段。当大量高并发真实企业级流量涌入时,这套体系能否在保持超低延迟的同时维持收支平衡,还得画上问号。
把模型做小、做快、做确定,确实击中当下行业痛点。但在未真正接受真实业务环境极端情况拷打之前,断言它已颠覆范式,还为时尚早。 过去几年,所有人都在惊叹AI越来越会说漂亮话。而现在终于有人意识到,在沉默的机器世界里,行动往往比语言更重要。