总榜第2 DeepSeek V4 Pro中文测评出炉:编程能力暴涨
超级CLUE最新放出的中文测评报告显示,DeepSeek V4 Pro正式版拿下综合总榜第二。这款8月13日刚发布的旗舰大模型,在智能体编程板块进步显著。 据悉,该模型原生支持百万级长文本解析。官方宣称其在推理、编程及智能体任务上,已跻身行业第一梯队水平。
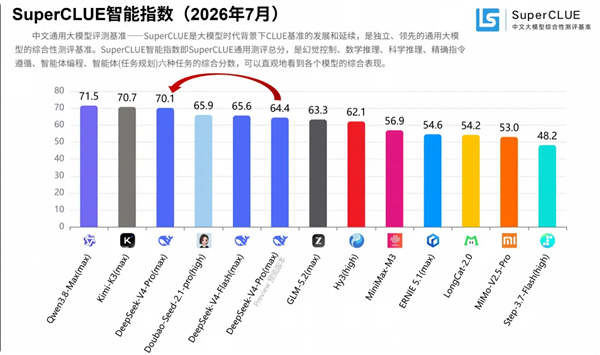
此次测评共邀请13个国产模型同台竞技,设置六大考核项。 值得注意的是,测评方特意提高了智能体编程的权重,占比达25%。这显示出对模型完成完整工程任务实力的重视。与预览版相比,其多项核心分数涨幅可观。 具体来看,智能体编程得分从47.37分升至63.16分,提升15.85分。
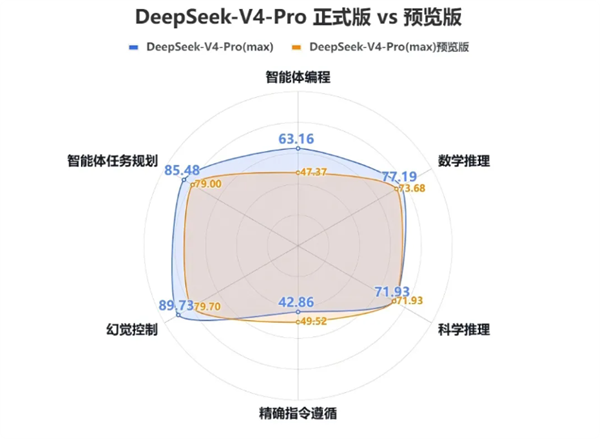
智能体任务规划上涨6.48分,幻觉控制从79.70分提升至89.73分。推理效能同步改善,耗时得到优化。 然而,迭代也有取舍。精确指令遵循分数出现小幅下滑。这表明开发团队优先强化了长链路智能体和深度推理能力。
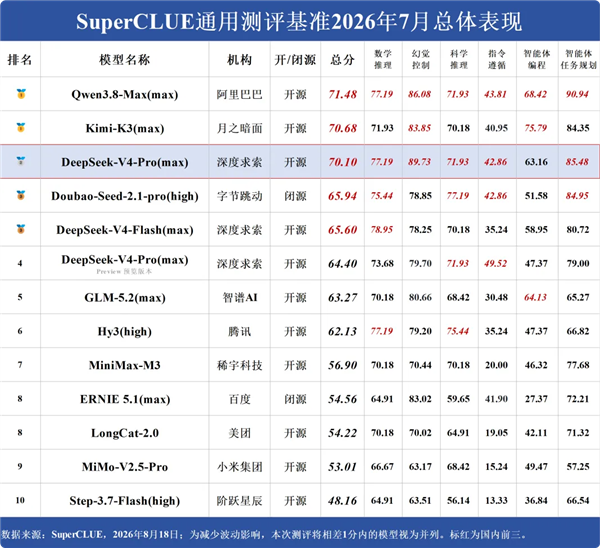
横向对比Qwen3.8 Max,前者在幻觉推理上表现更佳。 不过,在指令遵循和智能体编程方面仍有追赶空间。智能体任务规划还存在约5分差距。需说明的是,整套测试均为纯文本场景,智能体任务规划受此条件限制。
简单来说,本次更新最大看点在于编程与智能体能力,更适合写代码、做复杂任务规划的开发者。但模型并非全维度变强,部分能力尚有优化空间。普通用户和开发者选型时,建议结合自身实际需求进行判断。